你的"磁盘将满"告警在说谎:别再按百分比告警
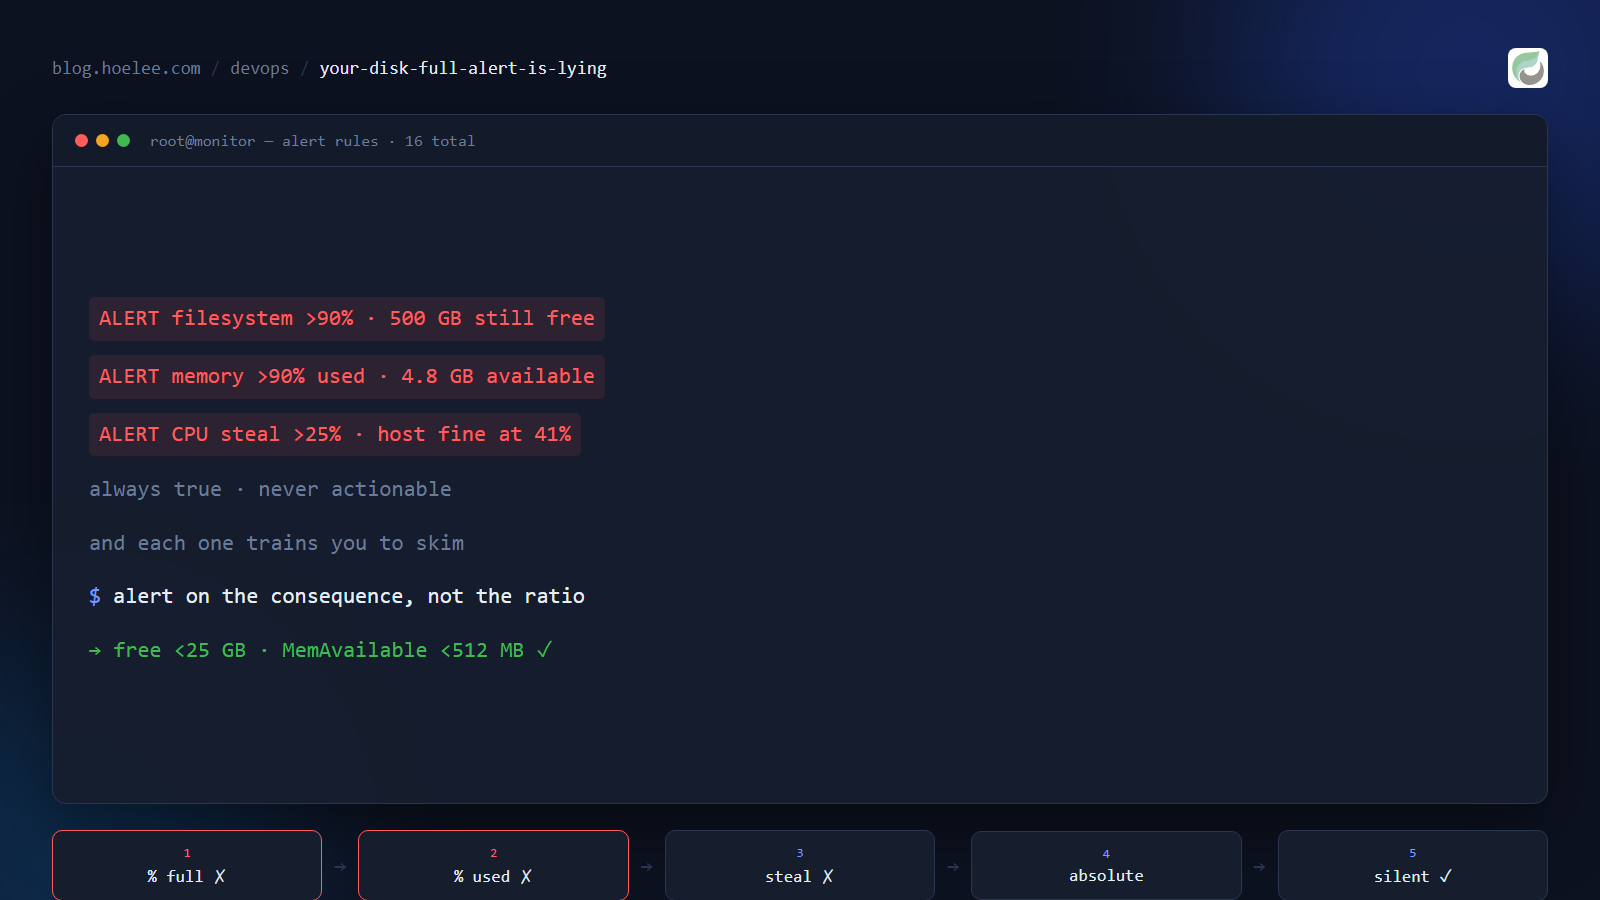
我搭好监控、写了一套看着合理的规则,然后用一个下午删掉了其中大半阈值。它们全是百分比,而且都以同一种方式错了。
三个教我道理的告警
1.「文件系统使用率超过 90%」——它在一个还剩约 500 GB 的 17 TB 卷上触发。没事发生,也不会马上有事发生。这种体量的卷,一次大备份就能让百分比摆动几个点:比例是噪声,而”还有 500 GB 可用”才是世界的真实状态。
2.「内存使用率超过 90%」——在一台可用内存 4.8 GB 的主机上反复触发。Linux 会用空闲内存做 page cache,需要时立刻归还;MemTotal - MemFree 描述的是文件缓存,不是你的风险。真正预示 OOM 的是 MemAvailable。
3.「CPU steal 超过 25%」——一台把邮件栈跑得完全正常的 VPS,steal 长期在 41%。steal 说明宿主机忙,它是容量信号而不是故障信号;7 vCPU 的机器 41% steal 就是这台机器的成本。这条规则产生的告警永远为真、也永远无用。
共同点:我在对比例告警,而比例不知道东西有多大。
对”后果”告警,而不是对比例
我现在对每个阈值都问一句:如果这个状态持续下去,实际会发生什么? 答案几乎总能用绝对单位表达。
| 不要这样 | 改成 | 原因 |
|---|---|---|
| 文件系统 > 90% | 剩余空间 < N GB | “我还能不能写进去”才是问题 |
| 内存使用 > 90% | MemAvailable < 512 MB | 逼近 OOM,而不是”缓存很暖和” |
| CPU steal > 25% | steal > 50% | 容量成本 vs 真的被饿死 |
| 负载 > N | load1 / 核数 > 2 | 不谈核数的负载没有意义 |
PromQL 的前后对比:
# BEFORE — 17 TB 卷的百分比;还剩半 TB 就开叫
(1 - node_filesystem_avail_bytes / node_filesystem_size_bytes) * 100 > 90

# AFTER — 真正装数据的卷上,还剩多少容量
min by (instance, mountpoint) (
  node_filesystem_avail_bytes{mountpoint=~"/volume[0-9]+|/mnt/ssd|/mnt/disk[0-9]+"}
) < 25e9
# BEFORE — 把 page cache 当成压力
(1 - node_memory_MemAvailable_bytes / node_memory_MemTotal_bytes) * 100 > 90
# AFTER — 真正的 OOM 前兆
node_memory_MemAvailable_bytes < 512 * 1024 * 1024两个让规则能活下来的细节:
把比较放进阈值条件里,不要塞进表达式。 查询就写 min by (mountpoint) (node_filesystem_avail_bytes{...}),让告警规则去和 25000000000 比。若你在 PromQL 里写死 < 25e9、规则里又留着继承来的 > 90,规则照样会评估——但界面显示的阈值是错的,下一个读它的人得从两个互相矛盾的条件下反推你的意图。
排除那些”只是另一个挂载点的视图”。 一条”剩余空间”规则有多诚实,取决于它的选择器。在我自己的环境里,同一个 NAS 卷出现三次(/volume1、/opt、以及在另一台主机上以 CIFS 再次挂载),而 unRaid 的 shfs 联合挂载报告 avail=0——不加排除的规则不是永远误报,就是把容量算成两倍。一个写明白的选择器胜过聪明的通用写法。
噪声不是无害的
坏阈值的代价不在告警本身,而在训练:每条”没事乱叫”的告警都在教你先扫一眼、然后忽略;等你真正该看的那条到来时,它出现在一个你早已不再读的频道里。我的规则总数减少了,覆盖率却上升了——更少,但每条都对应一个明确的后果。
阈值是私人的,形状是通用的
上面的数字是我的:NAS 卷剩不到 25 GB 我会在意、可用内存低于 512 MB 我才管、VPS steal 超过 50% 才算被饿。你的数字随硬件和容忍度而变。
能通用的是形状:
- 用绝对单位而非比例;
- 把后果写进告警的摘要里;
- 选择器明确声明它在替哪些挂载点说话;
- 规则数量少到你还能读完每一条。
结果
同一套栈,从”三条永久无用报警”变成 16 条在机房健康时保持安静的规则——其中一条立刻暴露了一个只剩 21 GB 的 NAS 卷,而那正是百分比规则一直藏在”99% 满的巨物”背后、被你学会忽略的东西。
需要为你的业务做这个吗?
如果你的监控在发你已经学会忽略的告警,或者你根本没有监控、宁愿从一条规则而不是从一次失败的备份里得知磁盘满了,我可以帮你搭自托管的监控与告警(Prometheus + Grafana,通知推 Telegram 和邮件),阈值按”什么会真的坏”来定。
WhatsApp:+60 12-797 2969 · 邮箱:[email protected] · hoelee.com
网站设计与开发是我的主业;服务器加固与自托管基础设施是它的另一半。