用一个 Prometheus 监控 unRaid、群晖 NAS 和 VPS:我做错的四件事
为什么这件事重要
当一台家用服务器在跑别人的网站、邮件和文件时,它就不是玩具了。糟糕的一周和糟糕的一个月之间,差别通常只是你多早发现:一块出现重分配扇区的盘、一个只剩 20 GB 的卷、一台被宿主机饿死的虚拟机、一个夜里重启四次的容器。
我有三台机器——unRaid(日常主力)、群晖 NAS(存储与服务)和 VPS(对外)——以及三套各自都不知道它们在干什么的方式。这篇文章讲它们如何变成一块屏,以及我路上做错的四件事——其中三个你也会踩。
架构
一个 Prometheus 加一个 Grafana,跑在永不关机的那台机器上。每台被监控主机跑两个 exporter:
| 机器 | 主机指标 | 容器指标 | 抓取路径 |
|---|---|---|---|
| unRaid | node_exporter (:9100) | cAdvisor (:8080) | 直连 |
| 群晖 DSM | node_exporter (:9100) | cAdvisor (:8082) | 局域网 |
| ServerHosh VPS | node_exporter (:9100) | cAdvisor (:8081) | VPN 隧道 + nginx stream 中转 |
node_exporter 与 cAdvisor 不是替代关系——这是最容易搞错的一点。 node_exporter 看的是主机:CPU、内存、网络、磁盘、文件系统、温度;它对 cgroup 一无所知,说不出是哪个容器吃掉了内存。cAdvisor 只看容器。想要主机健康和按容器记账,两个都得跑;少一个,那个洞会在几个月后表现为一次无法解释的负载高峰。
错误一:cAdvisor 里那些”不是容器的容器”
我的容器规则开始对不是容器的东西告警。cAdvisor 会为 systemd slice 和整机 cgroup 导出序列——其中一条没有名字的序列报告了约 58 GB 的”内存使用”,却没有对应的容器。那就是整台主机,被描述成了一个容器。
修法是加一个过滤条件,但你得先知道要写它:
# container metrics: anything with a name, and only that
container_memory_working_set_bytes{job=~"cadvisor.*", name!=""}
少了 name!="",一条”容器内存超过 10 GB”的规则会对主机自己告警。
错误二:我的”总容量”是虚构的
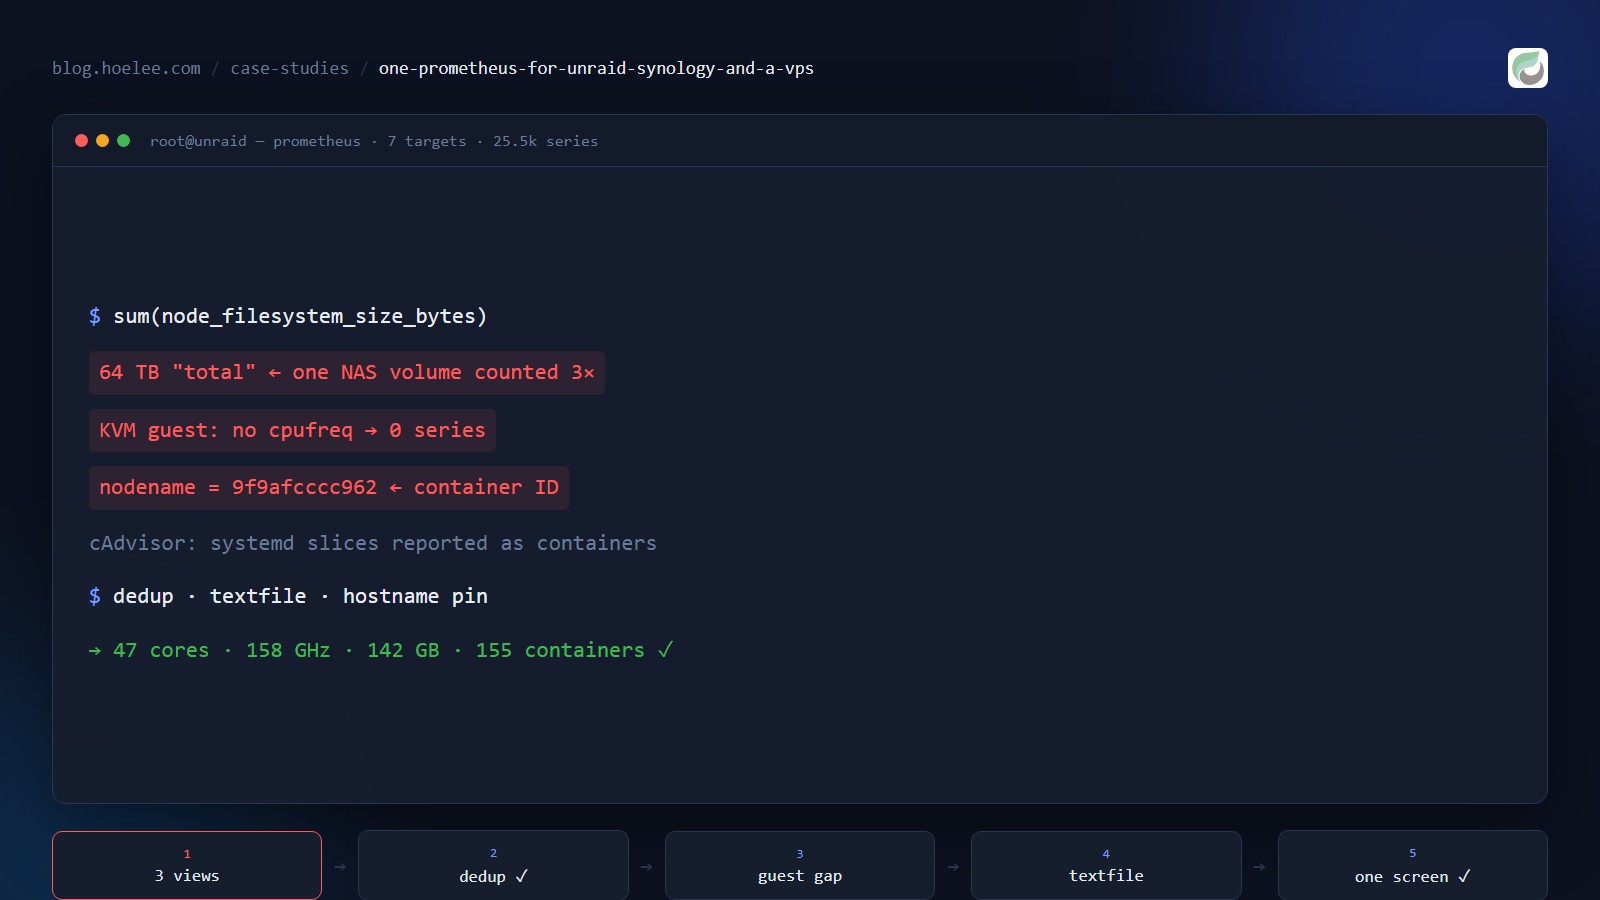
聚合面板好看,但就是错的。原因:同一个文件系统会在指标里出现多次。
- 在 NAS 上,主卷是
/volume1,而/opt是同一个 btrfs 文件系统,只是换了个挂载点。 - 在 unRaid 上,同一个 NAS 卷又以 CIFS 挂载成
/mnt/remotes/<nas>_ActiveBackup。 - unRaid 的
/var/lib/docker是那个池的子卷,而/mnt/ssd已经代表过同一个池——同样的字节,第二个身份。
所以朴素的 sum(node_filesystem_size_bytes) 报出了我并不存在的容量。诚实的写法是明确列出什么算数据存储:
node_filesystem_size_bytes{
  mountpoint=~"/volume[0-9]+|/mnt/ssd|/mnt/disk[0-9]+",
  fstype!~"fuse.*|tmpfs|rootfs"
} or node_filesystem_size_bytes{job="vps-host", mountpoint="/"}
还有两条应该写进面板说明的诚实备注,因为没人能解释的数字比没有数字更糟:
- 校验盘对内核不可见。 unRaid 的奇偶校验盘没有文件系统,所以从不出现在指标里——这个和是可用容量,不是硬盘数量。
- 镜像会虚增裸和。 两块镜像 SSD 会各报一次自己的字节,和不是你能存的量。
还有那个以后一定会咬我的遗漏:unRaid 的 shfs 联合挂载(/mnt/user)报告 avail=0。把它算进”剩余空间低于 X”的规则里,就会产生一条永远无法解除的告警。
错误三:那台不导出 CPU 频率的虚拟机
为了算全家的”总 CPU 频率”,我直接用 node_exporter 的 cpufreq collector。unRaid 和 NAS 都按核心报出了 node_cpu_scaling_frequency_hertz;VPS 什么都没有——它是 KVM 客户机,而客户机没有 /sys/devices/system/cpu/cpu0/cpufreq。这个指标在那里无法存在。
修法是 textfile collector:一个小脚本读客户机能看到的东西(/proc/cpuinfo),把 Prometheus 格式指标写进 node_exporter 会抓取的目录:
# /opt/node-exporter-textfile/cpu-mhz.sh — cron 每 5 分钟
awk -F: '
  /^processor/ { c = $2; gsub(/[ \t]/, "", c) }
  /^cpu MHz/   { f = $2; gsub(/[ \t]/, "", f); printf "node_cpu_mhz_current_hz{core=\"%s\"} %.0f\n", c, f * 1000000 }
' /proc/cpuinfo
配合:
command:
  - '--collector.textfile.directory=/textfile'
volumes:
- /opt/node-exporter-textfile:/textfile:ro两个刻意的决定:指标名故意不同于 node_exporter 自己的(用 node_cpu_mhz_current_hz,不用 node_cpu_scaling_frequency_hertz),这样万一以后宿主机暴露真实 cpufreq,不会出现重复序列冲突;仪表盘则显式合并两个来源:
sum(node_cpu_scaling_frequency_hertz or node_cpu_mhz_current_hz)错误四:exporter 把容器名当成了主机名
仪表盘的主机下拉框里出现了 9f9afcccc962。那是个容器 ID:node_exporter 的 uname collector 读到的是进程自己的 UTS namespace,而容器的 hostname 默认就是它自己的 ID。指标没错,标签毫无意义。compose 里一行解决:
services:
  node_exporter:
    hostname: 2.hoelee.com   # otherwise `nodename` = the container ID
我下次会怎么做
- 刻意把总览屏留到最后做。 “总容量是多少”这个问题会逼出全部去重工作;先做完三台主机面板再发现,就得在每个地方重做这个数字。
- 一开始就给容器钉 hostname。 一行成本,省掉一个让人困惑的下拉框。
- 假设每个虚拟化或家电式主机都会藏掉一类指标。 NAS 可能限制你的容器监控(DSM 的 Docker API 版本把我的 cAdvisor 钉在 v0.53.0——更新的版本要更新的 Docker API);虚拟机藏掉 cpufreq;路由器藏掉自己的 CPU。找缺口的方法是数你期待的东西,而不是相信”采集器成功了”。
结果
三台主机、7 个抓取目标、一个 Grafana、16 条告警规则,以及一块屏:47 个 CPU 核心 · 当前 158 GHz(标称上限 205 GHz)· 142 GB 内存 · 64 TB 存储 · 155 个运行中容器,并且每台机器克隆同一套主机/容器面板布局,三台读起来完全一致。告警进 Telegram 和邮件,Prometheus 保留 30 天。
最有用的产出不是仪表盘,而是重写存储规则那天触发的一条告警:一个只剩 21 GB 的 NAS 卷——它一直藏在”99% 满”的百分比阈值背后,而那个巨物早已变成背景噪声。
需要为你的业务做这个吗?
如果你有 NAS、VPS 和几台服务器,却没有一个地方能同时看它们,我可以帮你搭这样的自托管监控流水线——Prometheus + Grafana 覆盖你的机器,主机与容器指标,真正有意义的磁盘健康与容量规则,通知推到 Telegram 或邮件。
WhatsApp:+60 12-797 2969 · 邮箱:[email protected] · hoelee.com
网站设计与开发是我的主业;服务器加固与自托管基础设施是它的另一半。