Prometheus 明明有数据,Grafana 面板却全是 No data 的原因
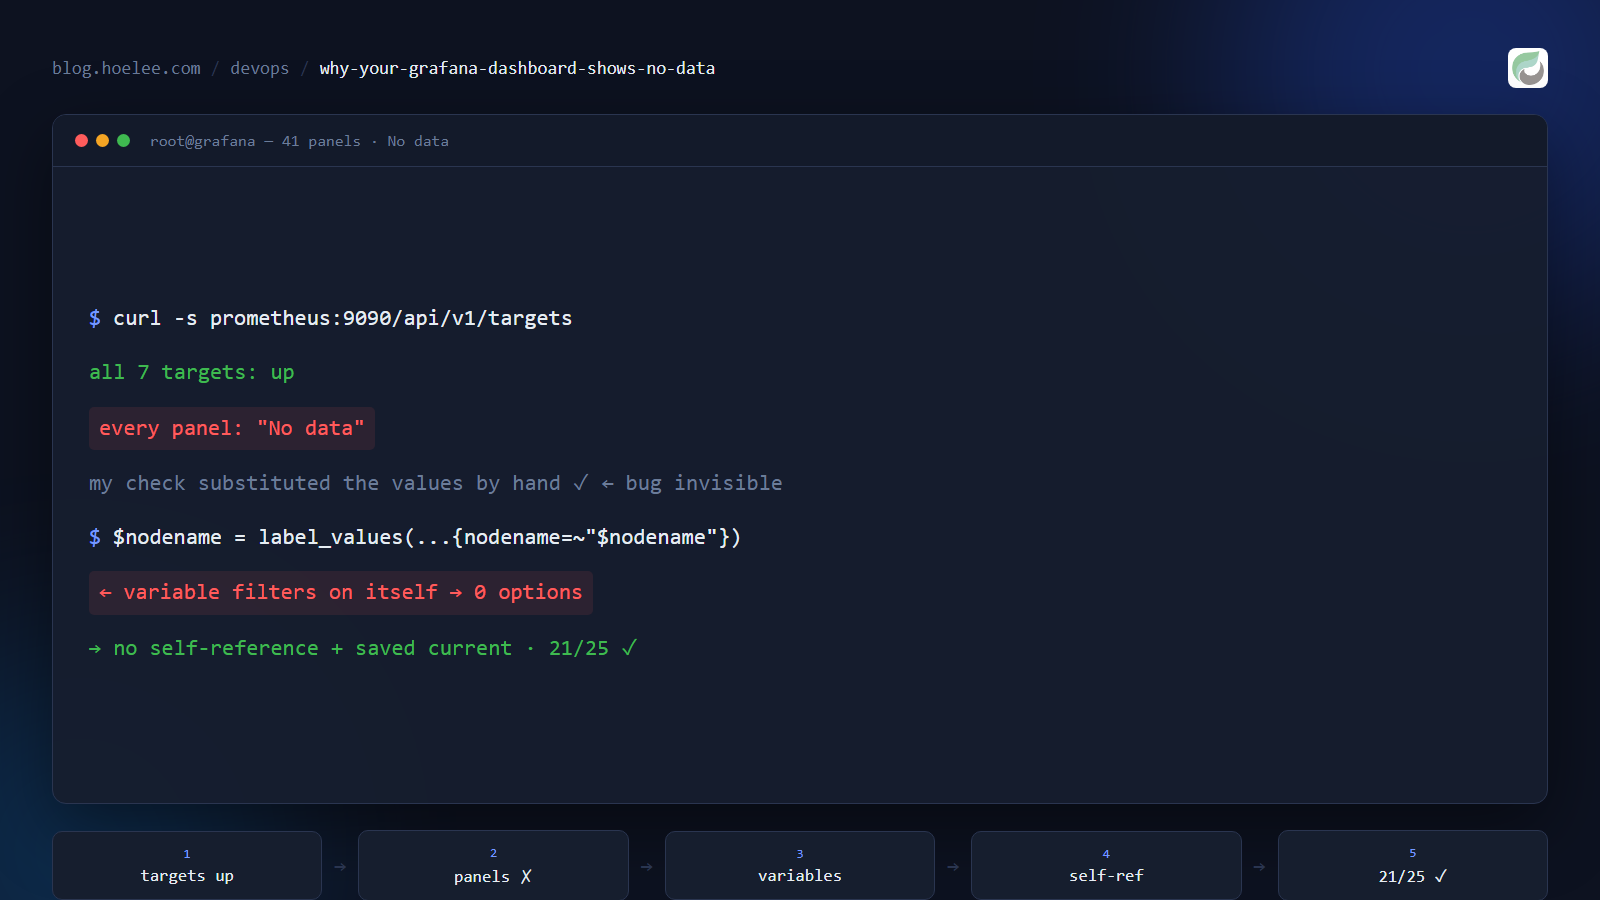
打开每天在看的面板,结果是空的。不是”某一格坏了”,而是从上到下每一格都写着 No data。去查 Prometheus,一切健康。这篇讲我踩到的那个具体且不直观的原因,以及为什么我自己的验证会同时告诉我”面板没问题”。
最省时间的排查顺序
常见原因(数据源选错、时间范围不对、rate() 用在会重置的计数器上、target 没被抓取)都不适用。真正有效的检查顺序是:
# 1. target 真被抓取了吗?
curl -s http://prometheus:9090/api/v1/targets | jq '.data.activeTargets[] | {job:.labels.job, health}'

# 2. 指标现在存在吗?(完全绕过 Grafana)
curl -s -G http://prometheus:9090/api/v1/query \
  --data-urlencode 'query=node_uname_info{job="unraid-host"}' | jq '.data.result[0].metric'

# 3. 面板表达式本身对吗?
curl -s -G http://prometheus:9090/api/v1/query \
  --data-urlencode 'query=count(node_cpu_seconds_total{mode="idle",job="unraid-host"})'
三项都过了:7 个 target up、2.5 万条序列在采集、手动跑面板表达式也有数据。所以问题不在指标、不在抓取、也不在 PromQL——而在它们之间的变量层。
真正的原因:变量过滤了自己
面板上有一个主机选择器,两个变量串联:$nodename(哪台机器)和 $node(它的 instance 标签)。第一个的定义是:
# BROKEN — 变量用自身的值来过滤自己
label_values(node_uname_info{job="unraid-host", nodename=~"$nodename"}, nodename)
首次加载时 $nodename 还没有值,选择器就变成 nodename=~""——什么都匹配不到。查询返回零行的变量没有任何选项,于是它保持空;而 $node 又是基于 $nodename 定义的:
label_values(node_uname_info{job="unraid-host", nodename="$nodename"}, instance)于是 $node 也是空,所有以 $node 为过滤条件的面板自然匹配不到序列。Grafana 说 No data 并没有骗人:面板查询真的没有数据,因为给它限定范围的变量解析成了空。
修法是去掉自引用,并给每个变量存一个明确的默认值:
# FIXED — 不自引用,每个变量只跳一层
# $nodename
label_values(node_uname_info{job="unraid-host"}, nodename)
# $node
label_values(node_uname_info{job="unraid-host", nodename="$nodename"}, instance)
为什么我的验证没抓到
这才是值得抄的部分。我”验证”面板的方式是:手动把每个面板表达式里的变量替换成我知道正确的值($nodename=unRaid、$node=host.docker.internal:9100),然后断言查询有数据点。13 项检查全部通过——面板依然是空的,因为 bug 在被替换的那个值上游:Grafana 自己对变量的解析是空的。
一个替换掉”可疑值”的验证,永远发现不了那个值解析失败。 要抓它,得读 Grafana 真实存下来的值:
curl -s -u admin:"$PW" http://grafana:4010/api/dashboards/uid/rYdddlPWk \
  | jq '.dashboard.templating.list[] | {name, current: .current.value}'
更直接的检查对象是变量查询本身——跑 Grafana 会跑的那条:
# $nodename 的 label_values() 到底返回什么?
curl -s -G http://prometheus:9090/api/v1/query \
  --data-urlencode 'query=count by (nodename) (node_uname_info{job="unraid-host"})' | jq '.data.result'
那里是空,面板就不可能渲染出来,无论数据多健康。
第二个坑:$__all 不是 .*
做自动化面板检查时,值为”All”的变量,其 current 是哨兵字符串 $__all——不是正则。把 name=~"$__all" 原样展开会匹配不到任何东西,于是完全健康的容器面板”全军覆没”。展开前要把 $__all 解析成该变量的 allValue(通常是 .*),否则你追的是一个只存在于自己检查脚本里的 bug。
不是每个空面板都是 bug
修完之后 25 个面板有 21 个出数。剩下 4 个是设计上就不可能有数据的,最好在面板说明里写清楚:
- PSI 面板需要
/proc/pressure,而这台 NAS 的内核不暴露它——指标在这台机器上无法存在;同样的面板在会导出node_pressure_*的主机上正常显示。 - 根文件系统面板的表达式带
fstype!="rootfs",而某台主机的/是内存盘(unRaid 就是),所以永远匹配不到。
区分”因为 bug 空”和”因为这台机器不可能有这个指标而空”,是真修好和瞎忙一下午的分界线。
我下次会怎么做
- 永远不要定义过滤自己的模板变量。 一个变量只跳一层。
- 给面板依赖的变量存明确的
current值,别让全新加载依赖下拉框被选中。 - 用 Grafana 存下来的值做验证,而不是我以为的值。
- 故意留空的缺口写进面板说明,否则未来的你会花一个下午去”修”一个本来就没打算工作的面板。
结果
三台主机现在跑同一套布局——每台一个 41 面板的主机面板 + 一个 10 面板的容器面板,分别有 21/23/25 个面板出数,两类结构性空缺写在面板里,而不是留给下一个打开它的人去猜。
需要为你的业务做这个吗?
如果你有一堆没人信任的 Grafana 面板,或者服务器和 NAS 完全没有监控,我可以帮你搭自托管的 Prometheus + Grafana(主机与容器指标、合理的告警规则、通知推到 Telegram 和邮件),也会把你那些悄悄”不出数”的面板修好。
WhatsApp:+60 12-797 2969 · 邮箱:[email protected] · hoelee.com
网站设计与开发是我的主业;服务器加固与自托管基础设施是它的另一半。