我差点把这颗 SSD 送修——真正坏的是 SATA 数据线
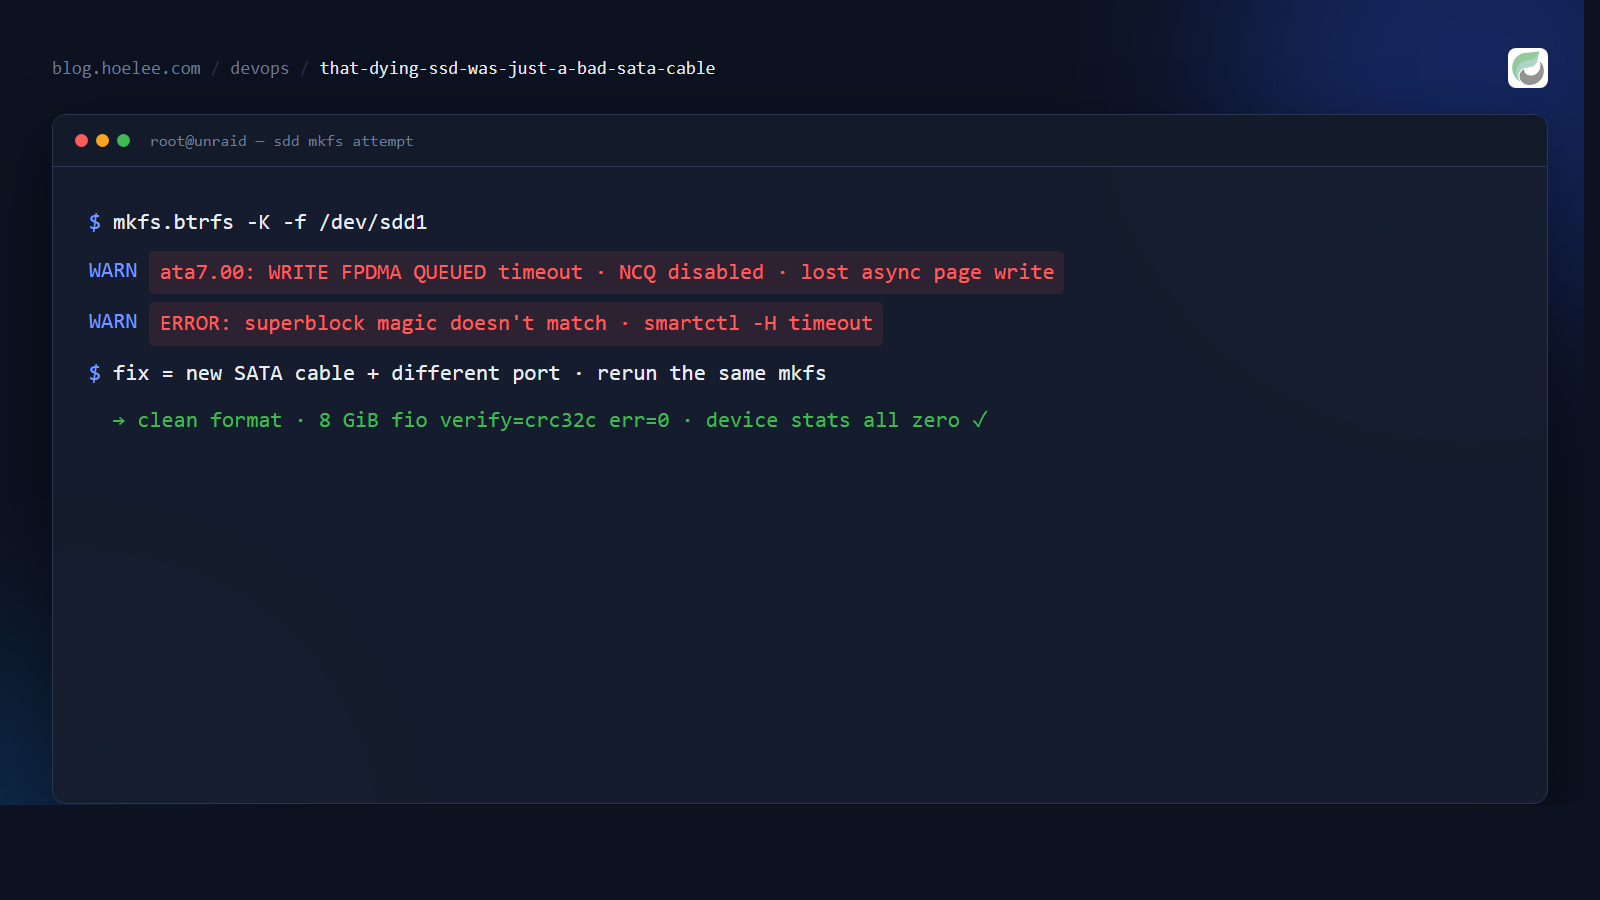
所有存储指南都告诉你:先看 SMART,再信事件日志。我也照做了,两者都指向同一个结论:这颗 SSD 要死了。而我距离把一颗健康硬盘送去 RMA 只差一步。
2026 年 9 月,一颗 Seagate IronWolf 110 960 GB SATA SSD——SMART 全绿、寿命约 99%、重映射扇区为零——反复在 btrfs mkfs 时失败,后来干脆连读都不回。内核日志里堆满了 WRITE FPDMA QUEUED 超时、NCQ disabled due to excessive errors、lost async page write。最后一次 mkfs 打印出 superblock 后,回读失败了。
只有一件事救了这颗盘:在判它死刑之前,我换了根 SATA 数据线。
为什么这很重要
一根有问题的 SATA 口或线材,会产生和坏盘一模一样的症状,而且 SMART 全程保持漂亮。线材故障发生在链路层——传输出错超时,内存在你的文件系统或 SMART 看到任何错误字节之前,就把这次 I/O 丢了。只靠 SMART 判断,你会冤枉健康硬件、发起一趟无意义的 RMA,而换上的新盘在同一根线上照样坏。
那些”盘要死了”的症状
这是一颗独立的 Seagate IronWolf 110(ZA960NM10001,企业级 SATA SSD,约 894 GiB),我准备把它加进 Unraid 缓存池。三件事陆续发生,全都很像坏盘:
-
内核日志每约 30 秒就循环一轮 libata 错误处理:
ata7.00: exception Emask 0x4 (timeout), WRITE FPDMA QUEUED, status { DRDY } ata7.00: exception ... action 0x6 frozen attribute NCQ disabled due to excessive errors Buffer I/O error on dev sdd1 ... lost async page write硬盘无法完成排队的写入,内核硬重置链路;降级之后它丢掉了真实数据——
/dev/sdd有 28 个 LBA 报 lost async page write。 -
mkfs.btrfs -K -f /dev/sdd1打印出完整的文件系统头,然后校验失败:Filesystem size: 894.25GiB ERROR: superblock magic doesn't matchbtrfs 写入了 superblock,回读时拿到的是不一样的字节。这是最可怕的静默写路径损坏。
-
之后
smartctl -H /dev/sdd超时。这颗盘连健康查询都不回应了。结合上面的写损坏内核标志,“送 RMA”是合理的结论。
改变结论的那个细节
排查到一半我必须物理移动这颗盘——它被接到另一个 SATA 口、换了根线。我在动任何其他操作之前,重跑了完全相同的 mkfs.btrfs 命令。
它通过了。零报错。btrfs device stats 全部清零。一次加了 verify=crc32c(写入带校验和的数据并回读核对)的 8 GiB fio 写入以 err=0 干净跑完,回读一致。smartctl 超时再也没有出现。dmesg 自那次换线以来对这颗盘零报错。
除了链路,什么都没变。那些”静默写损坏”,是 SATA 传输在线上损坏了帧,不是闪存的问题。
能抓到它 vs 抓不到它的测试
这一趟得出两个教训:
普通的 fio randrw 对这个故障是瞎的。 标准的 60 秒 randrw(70/30、4k、iodepth 32)写读随机扇区——但它从不核对读回来的字节是否和你写的一致。对一颗在线上损坏数据的盘,它会报 err=0、“干净通过”。我第一轮测试就是这样:干净,却在一颗随后 mkfs 失败的盘上。
你需要 verify,而且要点对区域。 fio 的 verify=crc32c 写入校验和并回读核对,这正是能揪出回读不一致的开关。而且故障是局部的:坏掉的 LBA(约 234,422,526–869,距设备起始约 111.8 GiB)落在我第一轮测试跑过位置再往后 100 GiB 处。在错误的偏移量上测试完全测不到。证据就是:指向健康区域的 verify 任务通过了;同一任务指向已知坏区间时,硬盘像先前缓存池故障时那样直接卡住。
# 判别性测试:写入带校验和,回读,不一致就失败
# 要么跑全表面,要么跑 dmesg 标记的精确 LBA 区间
fio --name=verify --filename=/dev/sdd \
    --offset=111G --size=2G \
    --rw=write --verify=crc32c --do_verify=1 \
--bs=4k --ioengine=io_uring --direct=1 --iodepth=32同一任务跑在健康盘上,verify 会通过;链路坏的话,fio 会报校验和不符或卡死——远比普通的 randrw 更早暴露问题。
我会改的做法
- 先换线。 在看到超时或写损坏时,在给盘判死刑之前,重新插拔/更换线材,或换到另一个口,重跑相同的失败命令。问题跟着端口走就是链路故障;跟着盘走(换了好口还坏)才是盘的问题。这是最便宜、最能一锤定音的测试,而我花了好几小时才做。
- 别信一个干净的
randrw。 它看不见静默损坏。凡是盘出现过任何写症状,都用verify=crc32c和do_verify=1。 - 对准日志里的 LBA 区间。 内核或文件系统已经标记了具体扇区的话,就在那里测,而不是从偏移 0 开始。
- SMART 全绿 ≠ 链路健康。 UDMA_CRC 为零只说明当前链路干净,它看不到过去那段不稳定的链路;而传输超时的页面在算出 CRC 之前就已经被丢了。
结果
这颗几分钟前就要被我送去 RMA 的盘,现在已经是一颗格式化好、挂载上、verify 全过的缓存 SSD,btrfs device stats 全部清零。修好它的成本:一根线。相信原有诊断的成本:一趟没必要的保修,还有一台迟早会在那根坏线上损坏数据的机器。
如果你在 NAS 或家用服务器上遇到一颗盘报 FPDMA 超时、但 SMART 看起来没问题——换线,别急着换盘。