换了不同的硬盘,同样的损坏又来了——真凶是 TRIM,不是 SSD
两周前我写了一篇文章,讲一个 btrfs RAID1 阵列如何在两块看起来完全健康的三星 PM9A3 NVMe 盘上静默损坏 Windows 虚拟机——读出来的全是全零数据块,单靠一块坏盘根本无法解释。那次调查以一句诚实的「不确定」收尾:两块盘测试都干净,最大嫌疑是它们共用的 M.2 转接卡。
然后它又发生了。在不同的硬盘上,走不同的总线。校验和指纹一模一样。这一次我找到了根因——而且跟 SSD 本身无关。
为什么这很重要
如果你在 Unraid(或任何 Linux 机器)上跑 btrfs RAID1 + SATA SSD + 自动 TRIM,这篇是给你的提醒:队列化 TRIM 正在同时、在同一位置、静默地摧毁我阵列的两份镜像。 RAID 冗余在这种损坏面前毫无保护力。而全程被 SMART 标记为「failing」的那块盘,跟真正的损坏一点关系都没有。
环境
- unRaid 7.x,Intel i9-13900K。
ssd池:两块 Seagate IronWolf 110 960 GB SATA SSD (ZA960NM10001,序列号HKR02TFK+HKR02L9P)组 btrfs RAID1, 挂载在/mnt/ssd,上面跑着 Docker 数据根目录(/var/lib/docker)和 Windows 11 虚拟机的虚拟磁盘(domains/Win11Enterprise/vdisk1.img)。- 虚拟机虚拟磁盘没有开
NOCOW,所以 btrfs 每次读取都会校验——和上次 事故能被发现靠的是同一个设置。
顺带一提:其中一块盘(sdd)正是 《我当时差点就去 RMA 这块 SSD——其实是 SATA 线坏了》
里那块盘——换线之后格式化干净,就进了这个池。
第一步——一个「假」的 SMART 故障
凌晨 02:53,Unraid 的通知铃响了:
Unraid Ssd disk SMART health [1] — Warning [UNRAID] -
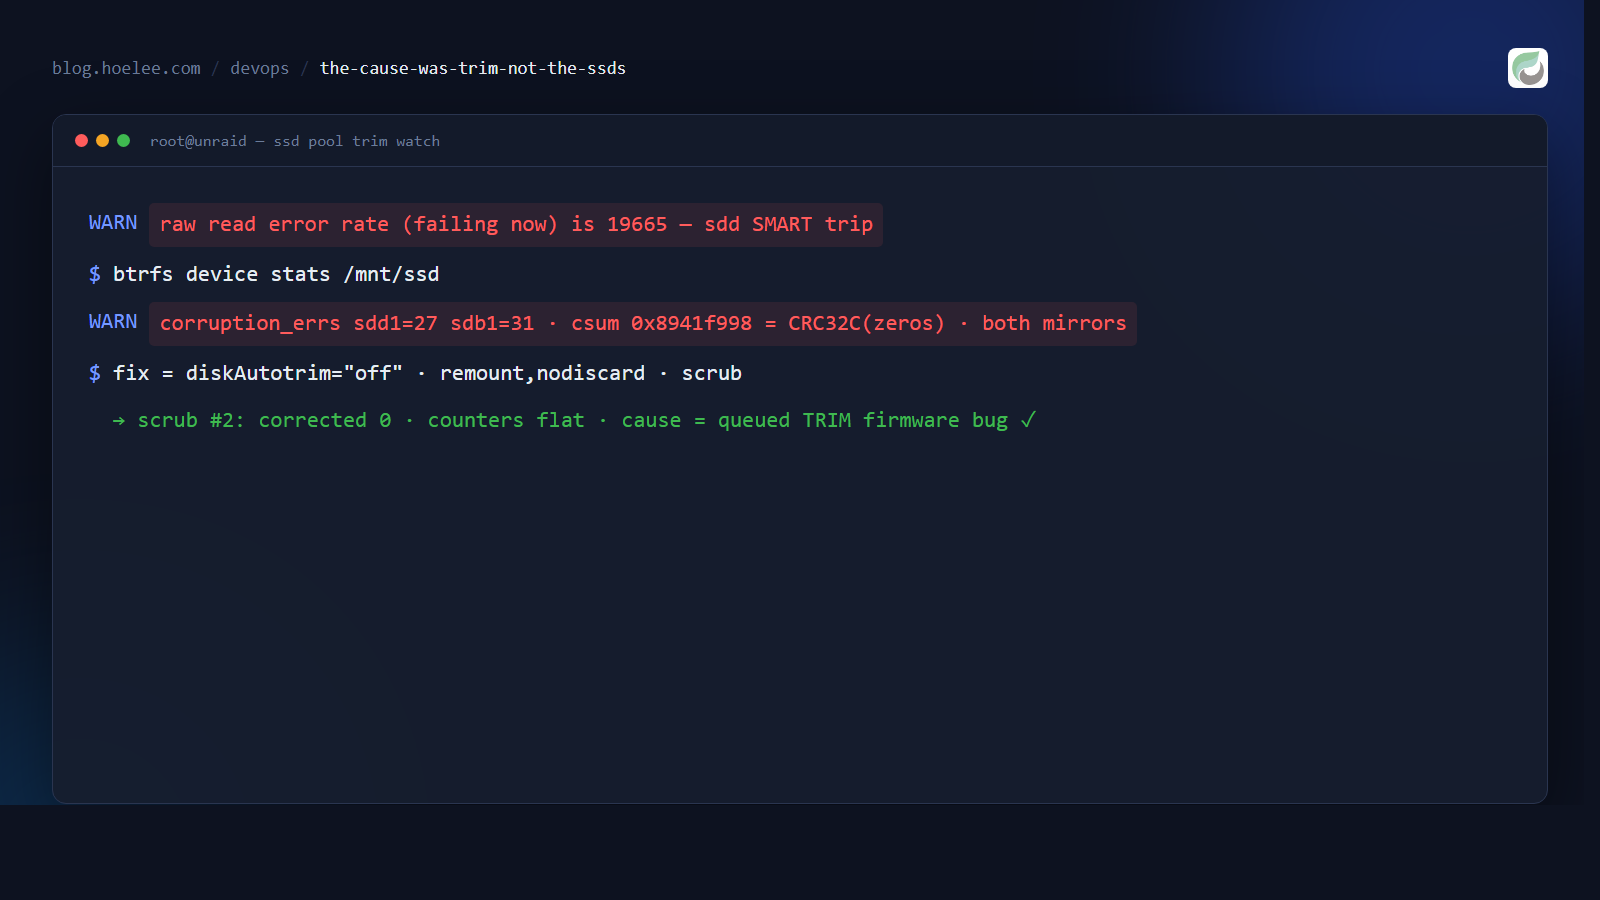
raw read error rate (failing now) is 19665   (sdd = ZA960NM10001_HKR02TFK)
「failing now」是 SMART 里最强的措辞——盘自报该属性跌破阈值。但在这些
Seagate 盘上,raw 值是障眼法:IronWolf 110 的属性 1 raw 字段是厂商编码的
复合值(高半部分是错误数,低半部分是操作计数)。19665 = 0x00004CD1 →
高半部分 = 0 个错误。真正触发的是归一化值:093,最差值 088,
低于 090 阈值,于是盘在 SMART 返回状态里自报 FAILING_NOW/IN_THE_PAST。
另一块盘(sdb)形状相同,raw 只有 341。
所有真实的故障计数器都是零:重映射 0、坏块增长 0、编程/擦除失败 0、 不可纠正 ECC 0、UDMA CRC 0、寿命剩余 99 %、SMART 总体 PASSED,刚跑完的 扩展自检也干净。这是 IronWolf 110 有据可查的行为——多年前 Synology 用户就 在 100 % 寿命时撞上过同样的「Failing」旗标,社区共识是:只要真实计数器不动, 这个型号的属性 1 触发就当固件噪音处理。
所以:盘是误报,但这次报警让我去看了——然后才找到真正的损坏。
第二步——一个不该存在的校验和
btrfs device stats /mnt/ssd:
[/dev/sdd1].corruption_errs 27 [/dev/sdb1].corruption_errs 31全部集中在同一个文件:ino 261 = Windows 虚拟机的虚拟磁盘。
dmesg 里是上一个 NVMe 事故里我盯了一周的同一个签名:
btrfs: checksum verify failed on logical 1505629372416 mirror 1 wanted 0x8941f9980x8941f998 是 4 KiB 全零块的 CRC32C。 池在读出空白块——而且关键的,是
在两块盘的相同逻辑偏移上同时读出。我翻了 PM9A3 阵列那次的笔记:值相同,
「确定性全零」行为相同,让 RAID1 失效的关联方式也相同。
这个匹配是指纹级的。无论这是什么,它都不是硬盘的问题,也不是 M.2 转接卡的 问题——IronWolf 这对盘走的是 SATA 口,完全不同的控制器路径。问题出在 比硬盘高一层:有一个机制决定同时擦掉两块盘上相同的数据。Linux 里恰好 只有一个机制干这事:discard / TRIM。
第三步——根因:在 Linux 从未拉黑的硬盘上跑队列化 TRIM
Unraid 的池配置开了自动 TRIM,btrfs 以 discard=async 挂载——内核批量收集
空闲块发给硬盘。对 SATA SSD 来说,那就是队列化 TRIM(DATA SET MANAGEMENT 命令以 NCQ 命令形式延迟执行,即 SEND FPDMA QUEUED)。
IronWolf 110 的队列化 TRIM 不稳定的问题早就被记录了。FreeBSD 内核有一个
文档化的报告——bug 264139,
「ata: NCQ_DSM_TRIM trim method for Seagate IronWolf 110 SATA SSD hangs drives」,
2024 年合并的修复提交写得毫不客气:commit a6cef617660a:
「Seagate IronWolf 110 SATA SSD 已被报告在启用 NCQ trim 时不稳定。」
而 Linux 自己的怪癖清单(drivers/ata/libata-core.c)——内核会在这里主动把
有问题的盘降级为非队列化或禁用 TRIM——收录了 Micron M500/M550/1100、
Crucial M500/M550/MX100、三星 840/850/860/870 等,但没有一条 Seagate
条目。我自己机器上的 dmesg 恰好证明这个机制存在而且在选择性生效:
ata6.00: Model 'Samsung SSD 840 PRO Series', rev 'DXM06B0Q', applying quirks: noncqtrim zeroaftertrim这条怪癖给了机箱里另一块 SSD,而两块 IronWolf 110 什么怪癖都没有, 拿到了完整的队列化 TRIM。
为什么这会毁掉 RAID1?因为 btrfs RAID1 在两块成员盘上存的是同一份空闲 映射——会在同一轮里对两块盘丢弃相同的逻辑区间。如果这个固件上的 TRIM 路径 会多失效(或失效错)LBA,就会同时清掉两块镜像上的同一批活动块。你的 镜像变成同一个洞的两份拷贝:两块盘都校验失败,自愈没有任何可抄的源,数据 彻底没了。
诚实的保留意见:FreeBSD 记录的是盘侧的不稳定/卡死,而「队列化 TRIM 抹掉 了活动数据」是我根据这个记录加指纹(双镜像全零、SMART 干净、CRC 错误计数 不涨)推断的机制。它符合每一条观察。证明靠实验——见下面的结果。
第四步——修复(持久化,一次只改一个变量)
只改一处,双管齐下——持久配置 + 热挂载:
# /boot/config/pools/ssd.cfg   (备份:/root/ssd.cfg.bak.20260918-0329)
diskAutotrim="off"                       # 原来是 "on"

# 不停阵列、不动 Docker(36 个容器全程在线)直接生效
mount -o remount,nodiscard /mnt/ssd
findmnt /mnt/ssd   # → rw,noatime,ssd,space_cache=v2   (不再有 discard=async)
然后做一次完整读写 scrub,搞清楚到底坏了多少:
scrub started 03:29:53, finished 03:53:07 (23 min)
csum_errors: 18    corrected_errors: 16    uncorrectable_errors: 2
read_errors: 0     verify_errors: 0        super_errors: 0
read/verify/super = 0 是指纹的另一半:硬件读盘完全正常——没有任何部件在
故障,只是盘上存的字节和校验和不符。18 个坏块里,16 块只有一块镜像坏,
已从完好副本自愈;2 个 uncorrectable 其实是同一个 4 KiB 块两块镜像都坏——
永久丢失,位于虚拟机虚拟磁盘约 45.2 GiB 处(logical 1505629372416,文件
偏移 48560156672)。我把这一个块填零,至少虚拟机读到那里不再报错;原始
字节无论如何都找不回来了。
还有一个值得知道的坑:scrub 跑了 18 个错误,btrfs device stats 计数器
却纹丝不动——scrub 发现的错误和读取时发现的错误是分开统计的。你没法只盯
device stats 一个数;dmesg 和 scrub 输出也得一起盯。(我的看门狗三样都查,
细节见文末。)
换成我会怎么做
- 任何 btrfs 池开自动 TRIM 之前,先查这块盘的队列化 TRIM 记录。
FreeBSD 维护一份「别给这盘发 TRIM」清单不是没有原因的。Linux 在
libata-core.c里有同样的机制——花一个下午 grep + 首次开机后看一眼dmesg,好过一次从备份里恢复虚拟机。 - TRIM 可以有,但不能队列化。 SATA SSD 想跑 fstrim 就强制非队列化
(
libata.force=…:noncqtrim),并在第一次 trim 后做一次 scrub 验证。discard=sync没用——只要盘支持,sync 同样走队列化路径。 - 三个损坏信号一起盯,别只看一个:
btrfs device stats、dmesg | grep 'csum failed'、周期性 scrub。三者各有各的计数器(见上文)。 - 并入池之前先交叉验证。 同批次、同固件的盘是关联故障风险;两块盘共一个 固件 bug 就是最坏的那种关联故障。镜像两次都没救得了我。
- 买企业级 SATA SSD 时:Linux 怪癖清单上的盘(Micron M500/M550/1100、 Crucial M500/M550/MX100、三星 840/850/860/870)以及一切有记录在案的 NCQ-TRIM bug(IronWolf 110)直接排除。三星 PM893/PM897、Micron 5400 PRO/MAX、Solidigm D3-S4610/S4620、WD Ultrastar DC SA620/SA630、Kingston DC600M 都有断电保护(PLP)且不在 Linux 怪癖清单上;而且 Micron、Solidigm、 WD、Kingston 会公开发布固件更新说明,真出了问题还能给你推送修复。NVMe 从根上绕开了 SATA 队列化 TRIM 这一类问题——我那两块 PM9A3 也不在 NVMe 怪癖表里。
结果
只改了一个变量(关自动 TRIM),其他原封不动。紧接着:
- 第二次 scrub(04:10–04:39):
corrected_errors: 0——16 块自愈块保持 住了,整盘重读没有出现任何新错误。 corruption_errs维稳在 sdd1=27 / sdb1=31,持续数小时的 Docker + 无虚拟机 运行(此前计数器是每天在涨的)。- dmesg 里没有新增
csum failed行。
确认窗口还有几天:Win11 虚拟机重新上线(它产生的是能复现问题的写入模式)、 对照基线文件每日检查、2026-09-22 再做一次复核 scrub。如果关了 TRIM 损坏还在, 下一个嫌疑就不是硬盘,而是内存(这台机器没有 ECC)——用 memtest 测。如果 一直平静,那 IronWolf 110 队列化 TRIM 固件 bug 就算坐实了——我敢说论坛里 「健康硬盘毁掉我的 RAID」的帖子,相当一部分也是它干的。
一个「正在故障」的 SMART 告警、一块零错误的硬盘、一个全新阵列上双镜像同时 损坏——每个迹象都指向别处,而真正的凶手是一个我们大多数人不假思索就开启的 存储功能。