Unraid 停止阵列时卡死的真相:Swapfile 锁住挂载点 — 附修复方案
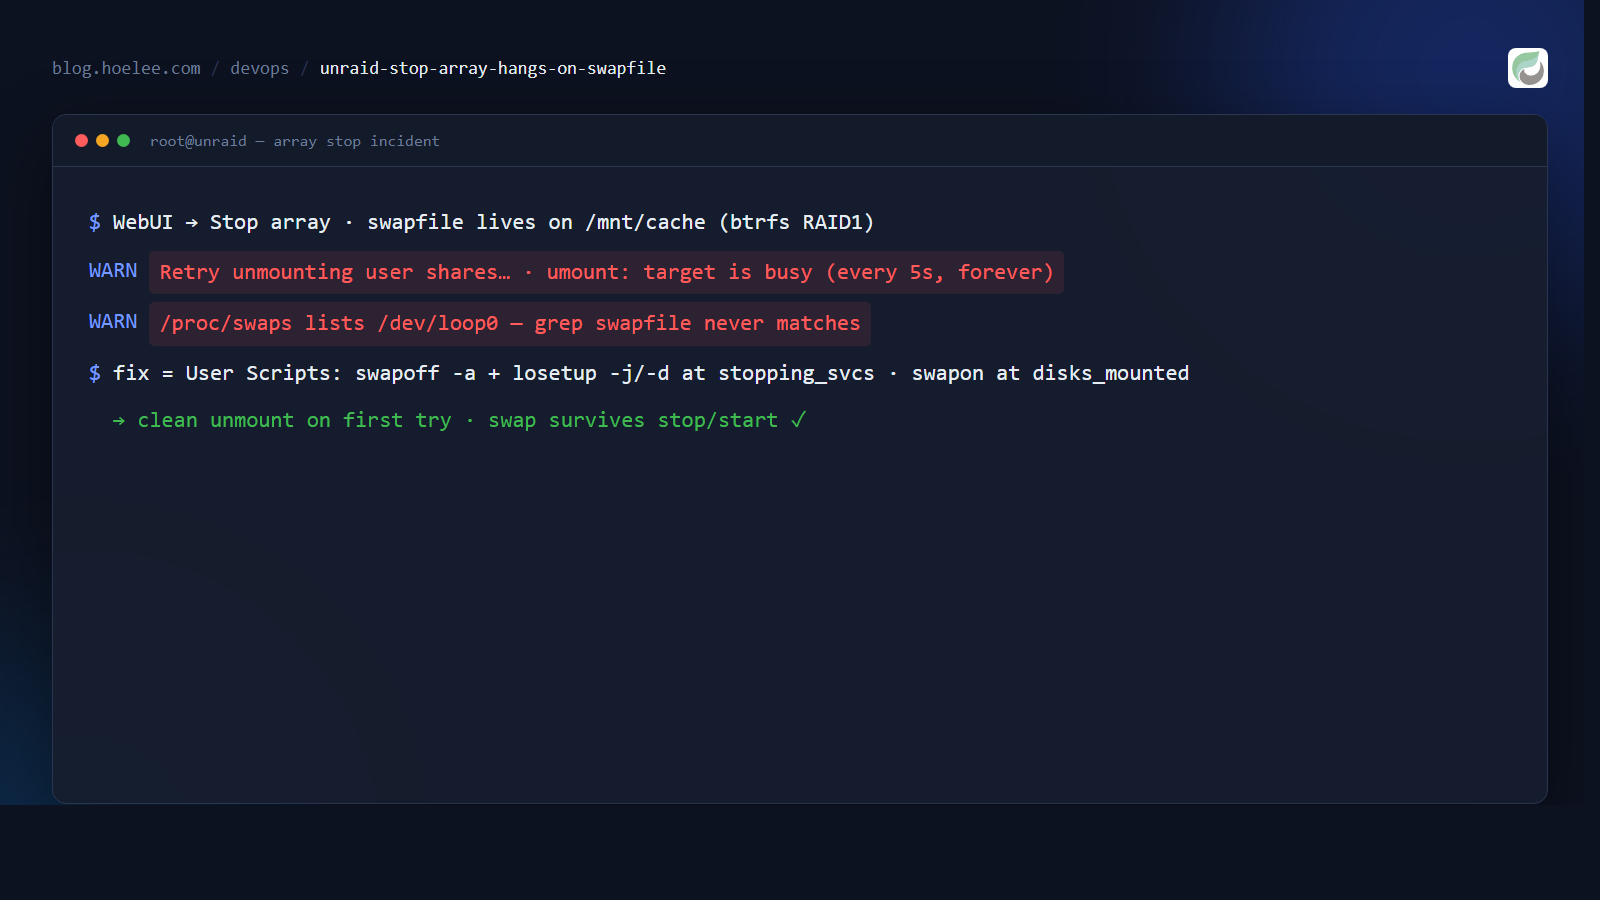
我给 Unraid 服务器加了 8 GB swapfile。缓存池是 btrfs RAID1,而内核不允许 swapfile 直接建在多设备 btrfs 文件系统上,所以走了 loop 设备这个标准变通方 案。Swap 生效了,内存压力降了,一切正常——直到有一天我点了「停止阵列」。
WebUI 永远停在 “Retry unmounting user shares…”。缓存池就是卸不掉。
Docker 已停、虚拟机已关、共享已卸载——umount /mnt/cache 依然每 5 秒报一
次 target is busy,无限循环。唯一出路是重启。
这篇文章讲清楚三件事:为什么会这样;我中途踩的坑(/boot/config/stop 在
你点「停止」时根本不会运行);以及两个脚本的修复方案——之后每次停止/启
动都干净利落。
问题本身(按你会搜索的方式来描述)
如果你是搜索进来的,你大概率在搜:
- “unraid stop array stuck retry unmounting user shares”
- “umount /mnt/cache target is busy unraid”
- “unraid swapfile stop array hang”
- “unraid 停止阵列 卡住”
同一个 bug。一句话版本:swapfile(或它的 loop 设备)被内核 swap 子系统
持有打开,而 Unraid 的停止阵列流程里没有任何一步会先关掉 swap 再卸载磁
盘。 挂载点忙,是因为内核自己在用它——除非有人执行 swapoff,否则它会
一直用下去。而没有人执行。
我试过的方案,以及为什么都失败
尝试 1:重启后再停阵列——照样卡死
意料之中。swapfile 配置在 /boot/config/go 里,每次开机都会重建 loop 设
备并启用 swap,每次停止都撞同一堵墙。至少这证明了问题是确定性的,不是偶
发进程卡住。
尝试 2:在 /boot/config/stop 里写 swapoff
这是最经典的陷阱,Unraid 官方文档让它看起来就是正确答案。stop 脚本的存
在意义就是「磁盘卸载前跑清理」——它确实会运行,但只在完整关机或重启
时。
我在自己的机器上验证过(Unraid 7.1.4):/boot/config/stop 由
rc.local_shutdown 调用,而后者在 rc.6 里。在 WebUI 点停止走的是完
全不同的路径——emhttpd 触发一系列 event——rc.6 根本不参与。没有关
机,就没有 stop 脚本,就没有 swapoff。阵列停止照样卡死。
尝试 3:搞清楚 GUI「停止」到底做了什么
真正的答案在这里。Unraid 的事件调度器(emhttp_event)在阵列停止时按文
档化顺序执行钩子脚本:
stopping → stopping_libvirt → stopping_docker → stopping_svcs
        → unmounting_disks → stopping_array → stopped
两个关键事实:
- 卸载发生在
unmounting_disks。任何 swapoff 必须在stopping_svcs或更早触发——比卸载早一个事件。 - 这些事件正是 User Scripts 插件暴露出来的调度选项(「At Stopping of
Array」=
stopping_svcs,「At First Array Start only」=disks_mounted)。不需要写新代码——自动化接口本来就在那里。
隐蔽的部分:/proc/swaps 对 loop swap 说谎
这是让「看起来正确」的清理脚本也会失败的坑。我的 /boot/config/go 原来
是这样配置 swap 的(btrfs RAID1 标准写法):
# /boot/config/go — 原始(停止时会卡的)配置
mkdir -p /mnt/cache
MOUNTPOINT=/mnt/cache
SWAPFILE=${MOUNTPOINT}/swapfile

# 等待缓存池挂载
while [ ! -f "${SWAPFILE}" ]; do
  sleep 1
done

# btrfs RAID1 拒绝直接 swapfile:loop 设备 + NOCOW
chattr +C "${SWAPFILE}"
LOOPDEV=$(losetup -f)
losetup -p 100 "${LOOPDEV}" "${SWAPFILE}"
swapon -p 1 "${LOOPDEV}"
现在看内核在活动状态下报告的内容:
$ cat /proc/swaps
Filename                Type        Size      Used    Priority
/dev/loop0              partition   8388604   0       -2

$ swapon --show
NAME       TYPE SIZE USED PRIO
/dev/loop0 partition  8G   0B   -2
文件名是 /dev/loop0,不是 /mnt/cache/swapfile。 所以这样的清理脚
本:
# 错误 — 对 loop swap 静默失效
grep -q '/mnt/cache/swapfile' /proc/swaps && swapoff /mnt/cache/swapfile……什么都匹配不到,什么都关不掉,然后你又一次卡在停止阵列。必须先解析
loop 设备——losetup -j <文件> 就是干这个的——再 swapoff 那个 loop 设
备,最后卸载它。ZRAM Compressed Memory 插件的源码注释几乎一字不差地记录
了同一个 bug:“for loop-backed swap, /proc/swaps lists /dev/loopN, not
the image path — a plain grep never matches, so swapoff never ran and the
loop device kept the pool busy forever.”(loop 型 swap 在 /proc/swaps 里显
示为 /dev/loopN 而不是镜像路径——普通 grep 永远匹配不到,swapoff 从未执
行,loop 设备让缓存池永远忙碌。)
修复方案:两个 User Scripts
大多数 Unraid 机器已经装了 User Scripts 插件。创建两个脚本:
脚本 1 —「Array Stop Swapoff」——调度选 At Stopping of Array(在
stopping_svcs 触发,比卸载早一个事件):
#!/bin/bash
# 先释放所有 swap,再只卸载【我们的】swapfile 背后的 loop 设备。
swapoff -a 2>/dev/null
for l in $(losetup -j /mnt/cache/swapfile 2>/dev/null | awk -F: '{print $1}'); do
  losetup -d "$l" 2>/dev/null
done
losetup -j(「哪个 loop 设备挂在这个文件上?」)是关键一步——它不受
/proc/swaps 命名谎言的影响。而且只卸载我们自己的 loop 设备很重要:机
器上可能还有别的 loop 设备(挂载的 ISO、其他镜像),它们必须在停止阵列时
存活下来。
脚本 2 —「Array Start Swapon」——调度选 At First Array Start
only(在 disks_mounted 触发):
#!/bin/bash
# 缓存池挂载后重建 loop swap。
[ -f /mnt/cache/swapfile ] || exit 0
LOOP=$(losetup -f)
losetup -p 100 "$LOOP" /mnt/cache/swapfile && swapon -p 1 "$LOOP"
为什么选「First Array Start only」而不是普通的「At Startup of the
Array」?因为开机时 /boot/config/go 也会运行并配置一次 swap。开机后的
第一次阵列启动由 go 负责;这个脚本真正管的是不重启、纯 GUI 停止 →
启动的循环——而 go 永远看不到这种场景。(在我的配置里,我把 swap 那段
从 go 里整个移除了,让 User Script 成为唯一事实来源——一处配置,两条路
径都覆盖。)
之后:停止 → 缓存池第一次尝试就干净卸载。启动 → swap 恢复。多次停止/启动 循环和重启后都验证通过。
我会做得不一样的地方
1. 不要把 swap 放在已经快死的盘上。 我的缓存池是一对后来确认在静默损 坏数据的 NVMe(SMART 全绿,读取却返回全零块)。8 GB swapfile 放在那里意 味着对我即将更换的硬件持续写入磨损——而且它正是在迁移期间卡住我阵列停止 的元凶。swap 的位置要匹配磁盘健康状况,而不是图方便。
2. CPU 够用时,压缩内存 swap 优于磁盘 swap。 这台机器的最终方案是 ZRAM Compressed Memory 插件:Tier-1 swap 放在 zstd 压缩的 RAM 块设备里。两个好处:
- 卡死在结构上变得不可能。 zram 设备不是挂载点,
umount /mnt/cache永远看不见它,停止时无需释放任何东西。(如果你启用它的 Tier-2 磁盘 swapfile,插件也自带正确的event/stopping钩子,用的正是losetup -j这个修复。) - swap 换入换出是微秒级 CPU 操作而不是磁盘 I/O——在现代多核 CPU 上, 压缩相对 NVMe 延迟几乎免费,而且被换出的页面在 RAM 里省约 3:1 空间。
一个我用惨痛教训学到的注意事项:插件的自动大小(RAM 的 50%)在我 62 GB 内存、已用 90% 的机器上给了一个 31.3 GB 的 zram 设备。那个数字是未压 缩上限——实际 RAM 消耗 = 容量 ÷ 压缩比,所以装满的 31.3 GB zram 可能吃掉 10–30 GB 我本来就稀缺的空闲内存。在接近满载的机器上,zram 要固定且保守地 设置大小(我改成 8 GB——原来 swapfile 的大小——swappiness 150),让它缓冲 OOM 而不是和 OOM 抢内存。
3. swap 只能推迟 OOM,治不了 OOM。 我内存压力的诚实根因是虚拟机内存 分配,不是缺 swapfile。swap 买来了余量、让宿主机在峰值时活了下来——但真正 的修复是给虚拟机合理分配内存。
结果
停止阵列从「永远卡死、强制重启」变成「第一次尝试就干净卸载」,swap 在停止/
启动循环之间自动存活,无需人工干预。修复总量:两个 shell 脚本,跑在一个早
就装好的插件里。贵的部分是知道该把它们放在事件序列的哪个位置——以及
/proc/swaps 不会告诉你 loop swap 的真相。
如果你的 Unraid 阵列拒绝停止,而你配置过任何形式的 swap——文件、loop 或其
他——在 root shell 里执行 swapoff -a 会立刻释放它,诊断就此确认。然后在
下次重启抹掉你的记忆之前,把它自动化。
你也有需要这种深度调试的自托管环境吗——Unraid、Docker、反向代理、NAS 迁 移?这是我的本行:网站设计与开发是主业,自托管基础 设施是我钻研最深的领域。欢迎通过 WhatsApp 或 邮件联系 我。