数字商品的自愈式访问控制:NocoDB、n8n 与 AList
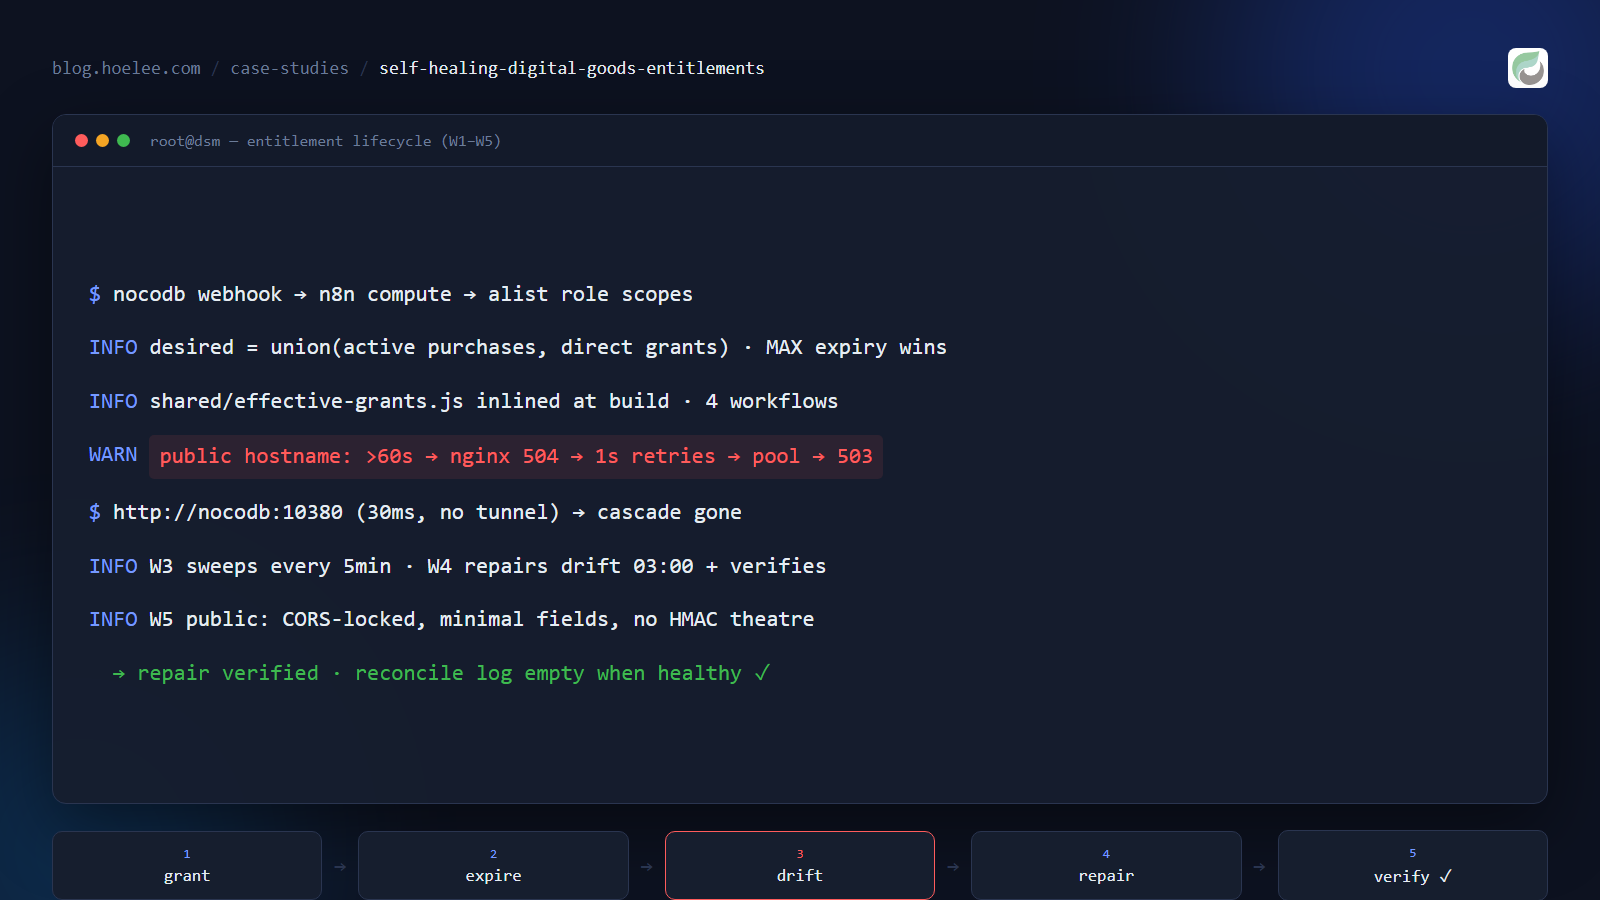
我卖数字产品——文件、美术素材、授权资源——并通过一个自建的文件门户交付。真正的难题从来不是存储,而是授权:确保客户在购买时拿到恰好他们买下的目录,拿到恰好他们付费的时长,并且在停止付费时访问权限真的被收回。
手工做这件事,前十个客户没问题。一百个就不行了,而且失败的方�式很具体、也很讨厌:静默失败。订阅到期而客户继续下载时,不会有任何报错。你只是一直在给一个几个月前就停止付费的人供文件。
所以我把它做成五个 n8n 工作流,把访问权限当作派生状态来处理——从我的业务数据库计算得出,应用到文件服务器上,并持续重新校验。下面是它的架构、让它可维护的代码共享技巧,以及那个公开接口背后的安全推理。
为什么这件事重要
对一个数字商品生意来说,访问控制就是产品本身。你保护的不是一座仓库,你保护的是你卖掉的那个东西。两种失败模式会真金白银地亏钱:
- 授予不足——付费客户拿不到他买的东西,而你是从愤怒的消息里而不是监控告警里知道的。
- 授予过度——已到期或已撤销的客户继续有访问权,而泄露会一直不可见,直到有人转卖你的目录。
手工管理最终会必然地导致这两种。解法是不要再把一次授权当成你做的一件事,而把它当成你数据的一个函数:给定客户当前的购买记录,他现在应该能访问什么?算出来、应用它,然后按计划证明它仍然成立。
系统的形状
五个工作流,每个只做一件事:
| 工作流 | 触发器 | 职责 |
|---|---|---|
| W1 — Customer Provision & Status Lifecycle | NocoDB webhook(客户行) | 创建/更新文件服务器用户;状态变更时启用或禁用 |
| W2 — CustomerProduct Sync | NocoDB webhook(购买行) | 重新计算并应用该客户被允许的路径 |
| W3 — Expiry Sync | Cron,每 5 分钟 | 扫描即将到期的授权;移除已失效的路径 |
| W4 — Daily Full Reconciliation | Cron 03:00 + 手动 webhook | 对比全体客户的期望与实际;修复漂移;记录日志 |
| W5 — Footer Purchase Check | 公开 GET webhook | 让门户展示客户自己的购买记录;只读 |
数据存在 NocoDB(一个自建的 Airtable 类数据库)里,包括 Customers、CustomerProducts、Products、Resources 和 AccessGrants 几张表。文件服务器是 AList,它为每个客户提供一个用户和一个角色,角色的 permission_scopes 就是一串路径。
至关重要的设计决策:NocoDB 是业务真相来源,AList 只是执行状态。 同步是单向的。在 AList 管理后台手动改一笔不算配置变更——那叫漂移,W4 会把它修复回去。
算法:这个客户应该有什么?
一切都系于一个函数。客户的期望路径是两个来源的并集:
- 所有可从有效的、未过期购买记录到达的资源。
- 所有通过有效的、未过期手工授权直接授予的资源。
有意思的情况是:同一个资源可以通过两个不同产品到达。如果客户买了产品 A(30 天后到期)和产品 B(200 天后到期),而两者都包含同一个目录,那么正确的到期时间是较晚的那一个——多买一样东西永远不该缩短你对它的访问权。
// 对每个产品的资源,按路径保留最大的 expires_at。
for (const c of cps) {
  if (c.status && c.status !== 'active') continue;
  if (c.expires_at && String(c.expires_at) <= today) continue; // 已过期
  const pid = linkId(c.product);
  if (!pid) continue;
  const res = (await ncGet(ctx,
    `/api/v2/tables/${T_PROD}/links/${LNK_PROD_RES}/records/${pid}`)).list || [];
  const exp = c.expires_at;
  for (const r of res) {
    const p = resPath[r.Id];
    if (!p) continue;
    const cur = desired[p];
    if (!cur || !cur.expires || (exp && exp > cur.expires)) {
      desired[p] = { expires: exp || null, permission: cur?.permission ?? 0 };
    }
  }
}注意边界:<= today。当天到期就算已过期。 到期检查上的一个差一错误,就是订阅期与白送一天之间的区别;如果你不把它写明确,你一定会写错,而且会错在对客户有利的那一边。
问题所在:n8n 的 Code 节点无法共享代码
这个约束塑造了整个代码库。n8n 的 Code 节点是自包含的:没有 require、没有 import、也没有访问共享模块的文件系统权限。所以最自然的结构——一个授权算法,被 W1、W2、W3、W4 调用——恰恰是这个平台不让你做的事。
把那个函数复制粘贴进四个节点,注定是一场维护灾难。四份到期规则的拷贝,就是四次它们互相不一致的机会,而一个用四种方式计算访问权限的系统,比没有系统更糟。
解法是让共享发生在构建期而不是运行期:
shared/effective-grants.js是唯一真相来源,而且它被写成自包含的:没有require、没有process.exit、函数外没有顶层return。它通过一个ctx参数({ $env, helpers })接收配置,而不是去抓全局变量——这带来一个令人愉快的副作用:它可以在 n8n 之外做单元测试。gen_w1.js、gen_w2.js、gen_w3.js、gen_w4.js读取这个文件,把它内联进工作流的 Code 节点主体,并更新工作流。
结果是:一个算法、四个工作流、零运行期依赖——而且这个函数可以在碰到任何线上系统之前,用纯 Node 测试。代码在产物里重复,但在源码里从不重复,这和打包器做的是同一笔交易。
一个 n8n 特有的细节值得知道:自定义环境变量只有在 Code 节点里通过 $env 才可靠可读——process.env 在那里不可靠。 这就是为什么每个工作流都有一个显式的「Load Env」节点,把它需要的值提升到 item 上,而不是哪里方便就在哪里读配置。
让到期处理可以安全自动化
W3 每五分钟跑一次,对即将到期的授权做对账。有两个细节让一个 cron 任务可以安全地改动线上权限:
只有当访问权限真的用完时才禁用。 一个天真的「如果没有期望路径就禁用用户」规则是危险的——它会乐于禁用一位只是还没被授予任何东西的新客户。守卫条件是显式的:
// 只在「曾经有权限、现在一个都没有」的客户身上禁用。
// currentPaths.length > 0 避免干掉一个全新的、尚未授权的客户。
const shouldDisable = AUTO_DISABLE && nowEmpty
  && cust.status === 'active' && currentPaths.length > 0;
它有 dry-run 模式。 容器上的 W3_DRY_RUN=true(或 W4 手动 webhook 上的查询参数)会让扫描计算并报告它的计划,同时执行零写入。能在让一个计划任务动手之前先问「你会做什么?」,是我在任何自动化里加过的最有用的安全功能。
const DRY_RUN = ($env.W3_DRY_RUN || '').toLowerCase() === 'true';每日修复:假定你一定会漂移
W4 是那个我会说才是真正产品的工作流。它在 03:00 运行,遍历每个客户,对比期望状态与实际状态——然后修复差异并验证修复。
它处理的漂移矩阵:
- 应当是有效的 → 用户必须存在(先用用户名查找,以避免在存储的 ID 丢失时创建重复用户)、处于启用状态,并且恰好带有计算出的角色权限范围。
- 应当是无效的 → 禁用,并清空权限范围。待处理客户完全不建用户——不自动创建。
- 悬空引用 → 存储的用户或角色 ID 指向一个已不存在的记录。按名字查找,找到就收编,找不到就重建。
- 用户名漂移 → 只检测并记录日志,绝不做破坏性迁移。
每一次修复之后都会重新读取文件服务器状态来验证。失败验证会被记为 verify_failed 而不是假定成功,而对账日志只接收漂移、修复和错误三类记录——健康客户不产生任何行。最后这个选择正是让日志可用的原因:如果它是空的,一切正常,你不必读着一千行「无变化」去找那一条重要的。
那个公开接口,以及为什么没有 HMAC
W5 让文件门户的页脚能展示已登录客户自己的购买记录和到期日期。它是一个公开 webhook,而它的安全推理是我最刻意对待的部分。
直觉是用 HMAC 给请求签名。我没这么做,理由值得直说:密钥必须发到浏览器,所以签名只是表演。 一个每个客户端都持有的共享密钥什么都保护不了——它只增加了一层仪式,让这个接口看起来经过验证。
所以这个接口依赖的是真正成立的东西:
- CORS 锁定单一来源。 响应带有
Access-Control-Allow-Origin: https://drive.example.com,所以只有门户自己的页面能在浏览器里读取响应。 - 数据最小化是设计出来的。 响应只返回产品名、到期日期、展示状态和公开目录路径。没有内部数据库 ID、没有客户个人信息、没有任何其他客户的信息。
- 边缘限流,通过请求路径上的一条 WAF 规则,削弱用户名枚举。
还有一个细微的架构选择:用户名来自调用者自己的会话 token,在客户端解码,而不是来自一个客户端可以自由设置的参数。这个接口从不向文件服务器认证,从而避开了一整类连接状态与设备注册副作用——否则每次页脚渲染都会引入这些副作用。
诚实的说法是:这个接口不是信任边界,我也不假装它是。它向客户展示的只是他们本来就知道的关于自己的信息,走的是一个对任何其他人无用的响应形状。
教会我最多的那个 bug:公网路径与级联故障
W5 最初是通过 NocoDB 的公网主机名——穿过一个 Cloudflare 隧道——去取数据的。测试中它工作良好。在真实负载下,它产生了这样一条链:
- 公网往返延迟在负载下超过 60 秒。
- nginx 上游超时触发 → 504。
- 页脚客户端 fetch 的 8 秒超时每秒重试一次。
- 重试堆积了连接。
- 这些连接耗尽连接池 → 无关请求收到 503。
一个慢依赖变成了一次不同服务的级联故障。修法是停止跨过整个互联网去访问同一个 Docker 网络上的东西:
// n8n 与 NocoDB 同处 bridge_hoelee 网络;NocoDB 监听 :10380。
// 走公网路由会引入 CF 隧道抖动,且可能超过代理超时。
const NOCODB_URL = 'http://nocodb:10380';
内部约 30 ms,公网 300 ms 以上,且没有隧道抖动——整条故障链消失了,因为触发条件(数秒级延迟)已不可能出现。
这个教训可以很好地泛化到这个技术栈之外:当一个服务和它的依赖在同一个容器网络里时,用公网主机名就是一个等着负载来触发的 bug。 而当你看到一个 503 出现在一个 504 的下游时,去找那个激进重试的客户端——重试循环通常才是放大器,而不是原始问题。
我会怎么做得不一样
- 先做漂移修复,而不是最后做。 我先写授权路径,然后到期扫描,最后才对账。回头看,对账才是让另外两个可以安全运行的东西,它应该从第一天就存在——因为「假定你一定会漂移」是一种设计立场,不是一个功能。
- 在任何工作流之前先写期望状态函数。 它能待在
shared/里、能在 n8n 之外做单元测试,正是整个系统在四个工作流之间保持连贯的原因。如果我一开始就把逻辑粘贴进节点,我就会发布四份微妙的、彼此不同的到期规则。 - 永远不要在同一台主机的两个容器之间走公网。 这条让我真的经历了一次故障,而它现在是我默认应用的规则,而不是每个集成都要重新发现一次。
- 从第一天就把 dry-run 开关放进去。 事后加
DRY_RUN很容易;而在没有它的情况下运行一个会改动权限的计划任务,是几周完全不必要的提心吊胆。
结果
五个工作流跑完整个授权生命周期:数据库里的一笔购买在几秒内变成可用访问,到期每五分钟扫一次,每夜的完整对账修复任何漂移并验证每次修复。一切健康时对账日志是空的——而大多数日子里,它说的就是这件事。
值得带走的设计原则,是让这件事变得可控的那一条:别再「管理」访问权限,开始「断言」它。 把客户应该拥有什么定义成业务数据的纯函数,在数据变化时应用这个函数,并按计划重新断言它以捕获其他所有情况。这样系统就不需要你小心翼翼——它只需要你在一个函数里,一次性地正确。
想让你的生意也用上这套?
如果你卖数字产品,还在手工授予文件访问权限——或者你不确定上个月到期的客户是否真的已经失去访问权——我搭的正是这套东西:自建授权系统,访问权限从你的数据计算得出、自动到期、每夜自我修复。我熟悉 NocoDB、n8n、AList 和 Docker,并且会把文档一并交付,让你不用依赖我也能运维。
欢迎联系 [email protected] 或 WhatsApp +60 12-797 2969,也可以看看我在 hoelee.com 做什么。