n8n v1 升级到 v2:一个日志文件里的七项废弃警告
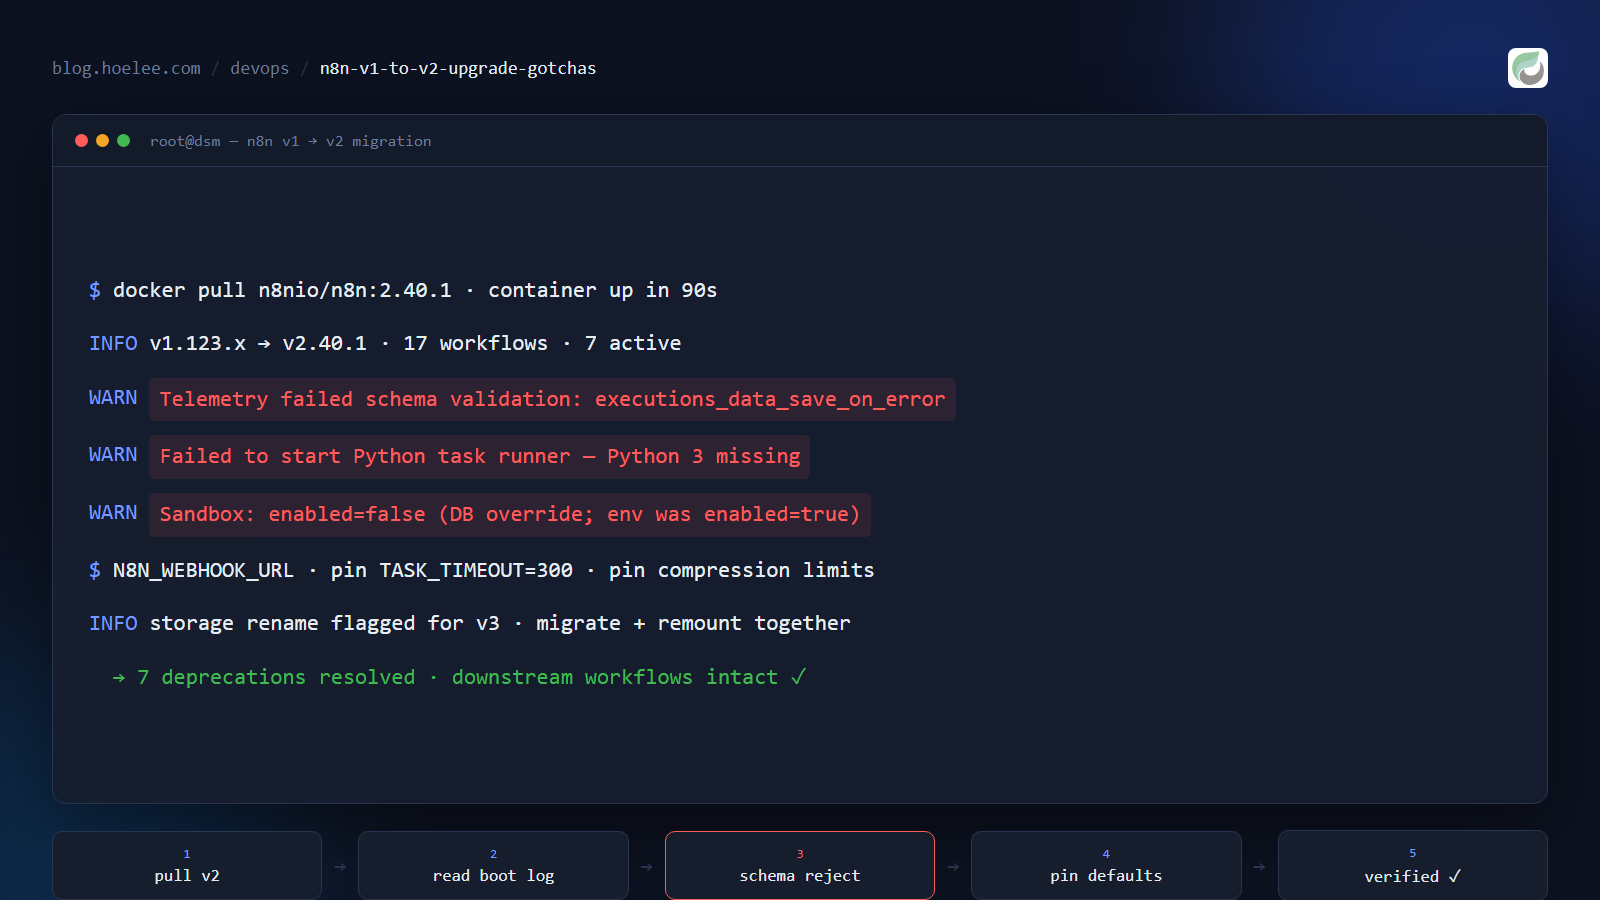
n8n 是我整个自建技术栈的自动化中枢——它负责文件交付权限、数据库备份,还有一套阅读应用依赖的语音合成 API。它一直停留在 1.123.x 版本线上快一年了,默默干活,没出过什么问题。
然后我拉了 n8nio/n8n:2.40.1 镜像并重启容器。升级本身只花了大约九十秒。而搞清楚它弄坏了什么花了我剩下的一整晚——而其中几乎所有信息,n8n 在启动时就已经写在一个日志文件里了。只是我第一次读得不够仔细。
这篇文章就是那个日志文件的解读,让你在规划自己的 v1 → v2 升级时能提前准备,而不是晚上十一点才发现问题。
为什么这件事重要
自动化平台的大版本升级,和其他服务升级的性质不一样。n8n 是运行其他一切东西的那个东西:它一旦起不来,你的备份、权限同步、内部 API 全部跟着停。更麻烦的是,v2 里坏掉的东西大多不会报错——它只打印一次废弃警告,然后就悄悄换了一种行为方式。
下面这七项,都是在一个真实的、有点混乱的、生产形态的安装上实际命中的。其中三项改变了我的技术栈的行为。还有一项,悄悄把一个功能关掉了。
从这里开始:n8n 在启动时会告诉你哪里不对
在动任何工作流之前,先从头读容器日志。在 v2 全新的启动过程中,n8n 会明确打印出一整块废弃警告:
There are deprecations related to your n8n setup. Please take the recommended
actions to update your configuration:
 - WEBHOOK_URL -> Use N8N_WEBHOOK_URL instead, which sets the base URL for
   both test and production webhooks.
 - N8N_UNVERIFIED_PACKAGES_ENABLED -> The default for this variable will
   change to `false` in a future version.
 - N8N_RUNNERS_MODE -> Internal task runner mode is deprecated and will be
   removed in a future version.
 - N8N_RUNNERS_TASK_TIMEOUT -> The default for this variable will be reduced
   from 300 (5 minutes) to 60 (1 minute) in a future version.
 - N8N_COMPRESSION_NODE_MAX_DECOMPRESSED_SIZE_BYTES -> The default will be
   reduced from 2 GiB to 256 MiB in a future version.
 - N8N_COMPRESSION_NODE_MAX_ZIP_ENTRIES -> The default will be reduced from
   5000 to 1000 in a future version.
这一块就是你的迁移清单。我那七项坑里的六项都在里面。
1. 你的环境变量值现在可能过不了 schema 校验
这是最让我困惑的一项,因为它看起来完全像一条无意义的报错:
Telemetry event "Instance started" failed schema validation:
execution_variables.executions_data_save_on_error: Invalid option:
expected one of "all"|"none"
我当时设置的是 EXECUTIONS_DATA_SAVE_ON_ERROR=error——这个值在 v1 里完全合法,而且是我刻意选的,因为对一台繁忙的实例来说,「只保存失败的执行记录」是合理的默认策略。但在 v2 里这个值已经不在允许集合内了,现在的合法值是 all 或 none。
失败方式才是关键。它没有崩溃。它甚至没有以一眼就能看出是错误的方式发出警告——它抛出的是一条 telemetry schema validation 消息,听起来像是 n8n 内部的问题,而不是我的配置问题。这个设置实际上被忽略了。
修法是把你的意图放到一个说得通的地方:选一个合法的值,然后用 pruning 控制数据量。
EXECUTIONS_DATA_SAVE_ON_ERROR=all
EXECUTIONS_DATA_SAVE_ON_SUCCESS=none
EXECUTIONS_DATA_PRUNE=true
EXECUTIONS_DATA_MAX_AGE=336
EXECUTIONS_DATA_PRUNE_MAX_COUNT=10000
教训: 在 v2 里,把你的环境变量当成一套有类型的、带 schema 的接口来看待。一个非法的值可能被静默丢弃,而不是大声拒绝。
2. WEBHOOK_URL 已被 N8N_WEBHOOK_URL 取代
如果你的 webhook 发布在反向代理后面——你几乎肯定是的,因为那是它们变得可访问的方式——那么这个 base URL 变量就是关键路径上的东西。它决定了 n8n 报告的是公网 webhook 路径,还是 http://localhost:5678/...。
旧名字目前还能用,所以这一项不会立刻咬你。但注意它的措辞:新变量为测试和生产 webhook 同时设置 base URL。在我的环境里这两者在行为上已经出现了分叉,而这次的合并正是为了消除这一类 bug。
# 升级前(仍可用,但已废弃)
WEBHOOK_URL=https://auto.example.com/

# 升级后
N8N_WEBHOOK_URL=https://auto.example.com/
3. Internal task runner 模式要取消了——而我的其实早就坏了
这一项一直在我的日志里,就在废弃警告块上面几行,而我已经读过去好几个月了:
Failed to start Python task runner in internal mode. because Python 3 is
missing from this system. Launching a Python runner in internal mode is
intended only for debugging and is not recommended for production.
如果你的任何工作流用了 Python 的 Code 节点,那它根本就没在 internal 模式下跑起来过——官方镜像里没有 Python。JavaScript 的 Code 节点是正常的(JS runner 会正常注册),所以这个问题可以无限期不被发现:一切看起来都是健康的。
v2 把方向挑明了:切到 external 模式,和一个独立启动器进程共享一个 auth token。
N8N_RUNNERS_MODE=external
N8N_RUNNERS_AUTH_TOKEN=<一串足够长的随机字符串>
教训: 「internal 模式已废弃」是标题,但真正的发现是:某一类 runner 可能已经静默失效好几个月了。要检查 docker logs 里的 runner 注册那行,而不是只看容器起没起来。
4. Task 超时默认值从 300 秒降到 60 秒
这一项是我最想替所有有慢工作流的人标红的:
N8N_RUNNERS_TASK_TIMEOUT -> The default for this variable will be reduced
from 300 (5 minutes) to 60 (1 minute) in a future version.
对自己的负载诚实一点。你有没有 Code 节点要遍历几千条记录,或者要调一个很慢的上游接口?我有——一个每夜的对账流程会遍历每个客户,每条记录调一次外部 API。在未来的某次升级中,它会在六十秒处停下,而我这边没有任何配置变更。
趁你人还在这个文件里,现在就显式设置:
N8N_RUNNERS_TASK_TIMEOUT=300对所有「默认值将会改变」形式的废弃警告,通用原则是:如果你依赖当前的默认值,就把它显式钉死。 否则这次升级就是一个静默的行为变更,而你会把它当成 bug 来排查,而不是认出它是一个过期的默认值。
5 和 6. 两个压缩节点上限缩水(2 GiB → 256 MiB,5000 → 1000 条)
这两项一起出现,只有当你在工作流里处理大负载的压缩/解压节点时才相关——而当你在工作流里搬运数据库导出或归档文件时,很容易就变成相关。
N8N_COMPRESSION_NODE_MAX_DECOMPRESSED_SIZE_BYTES -> reduced from 2 GiB to
256 MiB in a future version.
N8N_COMPRESSION_NODE_MAX_ZIP_ENTRIES -> reduced from 5000 to 1000 in a
future version.
内存上限降到八分之一,条目上限降到五分之一。不会报错;节点只是在一个你没设定的阈值处拒绝执行。如果你接近任何一个上限,两个都钉死。
7. 存储路径将在 v3 改名——而你的卷正好挂在旧路径上
这不是 v2 的破坏性变更,但 v2 会警告它,而且是真正涉及数据规划的那一项:
Deprecation warning: The storage directory "/home/node/.n8n/binaryData" will
be renamed to "/home/node/.n8n/storage" in n8n v3. To migrate now, set
N8N_MIGRATE_FS_STORAGE_PATH=true. If you have a volume mounted at the old
path, update your mount configuration after migration.再读一遍最后一句:如果你有一个卷挂载在旧路径上,请在迁移后更新你的挂载配置。 如果你设了迁移标志却保留旧的 bind mount,你现在就有两个目录,而你的二进制数据住在容器实际指向的那一个里。把改名和挂载变更放在同一个维护窗口里做——不要一个现在、一个「以后」。
那个不在日志里的:我的 AI 沙盒把自己关掉了
这是跟废弃警告毫无关系的发现,也是如果我不读完整的启动序列就永远抓不到的一项:
Sandbox: enabled=false provider=n8n-sandbox (DB override; env was enabled=true
provider=n8n-sandbox)我的环境变量说已启用。数据库说不是。数据库赢了。
环境变量是 N8N_INSTANCE_AI_SANDBOX_ENABLED=true,在容器上依然设置正确。但有一个持久化在 n8n 自己的配置存储里的值,在启动时覆盖了它——而这个冲突唯一被报告的地方,就是一行日志里的一个括号。
这是一个超越 n8n 的、非常有价值的排查教训:当一个功能明明环境变量设对了却是关闭状态,就怀疑存在一个优先级高于环境的持久化设置层。容器配置不总是最终答案。在日志里 grep 那个功能名,不要看到环境变量就停下。
我会怎么做得不一样
- 在宣布升级完成之前先读启动日志。 所有对我重要的废弃警告,都在第一次启动时、在一个块里、清清楚楚打印出来了。我的 v1 习惯是检查「它起来了吗、工作流跑得动吗」——而这恰恰是漏掉全部七项的检查方式。
- 把「默认值将会改变」当成待办事项,而不是警告。 七项里有五项是未来的默认值变更。现在钉死它们只需要改一次配置,却能把以后的一次神秘故障转化为一次配置 diff。
- 把容器配置和 n8n 自己存储的配置做对比。 沙盒覆盖这件事教会我:env 只是两个输入之一,不是真相来源。当行为和配置不一致时,相信行为,然后去找那个优先级更高的层。
- 钉死镜像 tag,并保留上一个。 我是从 v1 直接跳到
2.40.1的。本地留着旧镜像,是回滚能变成一条docker run而不是一次重新构建的原因。
结果
n8n 现在跑在 2.40.1 上,整块废弃警告都已处理:schema 非法的值已修正,N8N_WEBHOOK_URL 已就位,JS runner 正常注册,task 超时和压缩上限都已钉死,让下一次升级变成一次无操作而不是一次意外。
下游一切都还在工作——文件权限同步、每夜备份、语音合成接口。这才是这类升级值得追求的结果:不是「它起来了」,而是「它起来了,而且接下来三次升级的成本已经预付了」。
真正让人不舒服的地方在于,这些我本可以提前知道的信息占了多大比例。n8n 主动把整份清单递给了我,就在启动时。升级从来不是难的部分——读输出才是。
需要不用你天天盯着的自动化?
我搭建并维护自建自动化——n8n 工作流、Docker 技术栈,以及那些从来不是设计来互相通信的应用之间的胶水层。如果你正面临一次大版本升级,或者你有那种「能用,直到不能用」的自动化,我会规划迁移、在维护窗口执行、并把每一个配置决策都记录下来,让下一次升级变得无聊。
欢迎联系 [email protected] 或 WhatsApp +60 12-797 2969,也可以看看我在 hoelee.com 做什么。