我用两个 Cron 容器跑了一年的语音合成服务
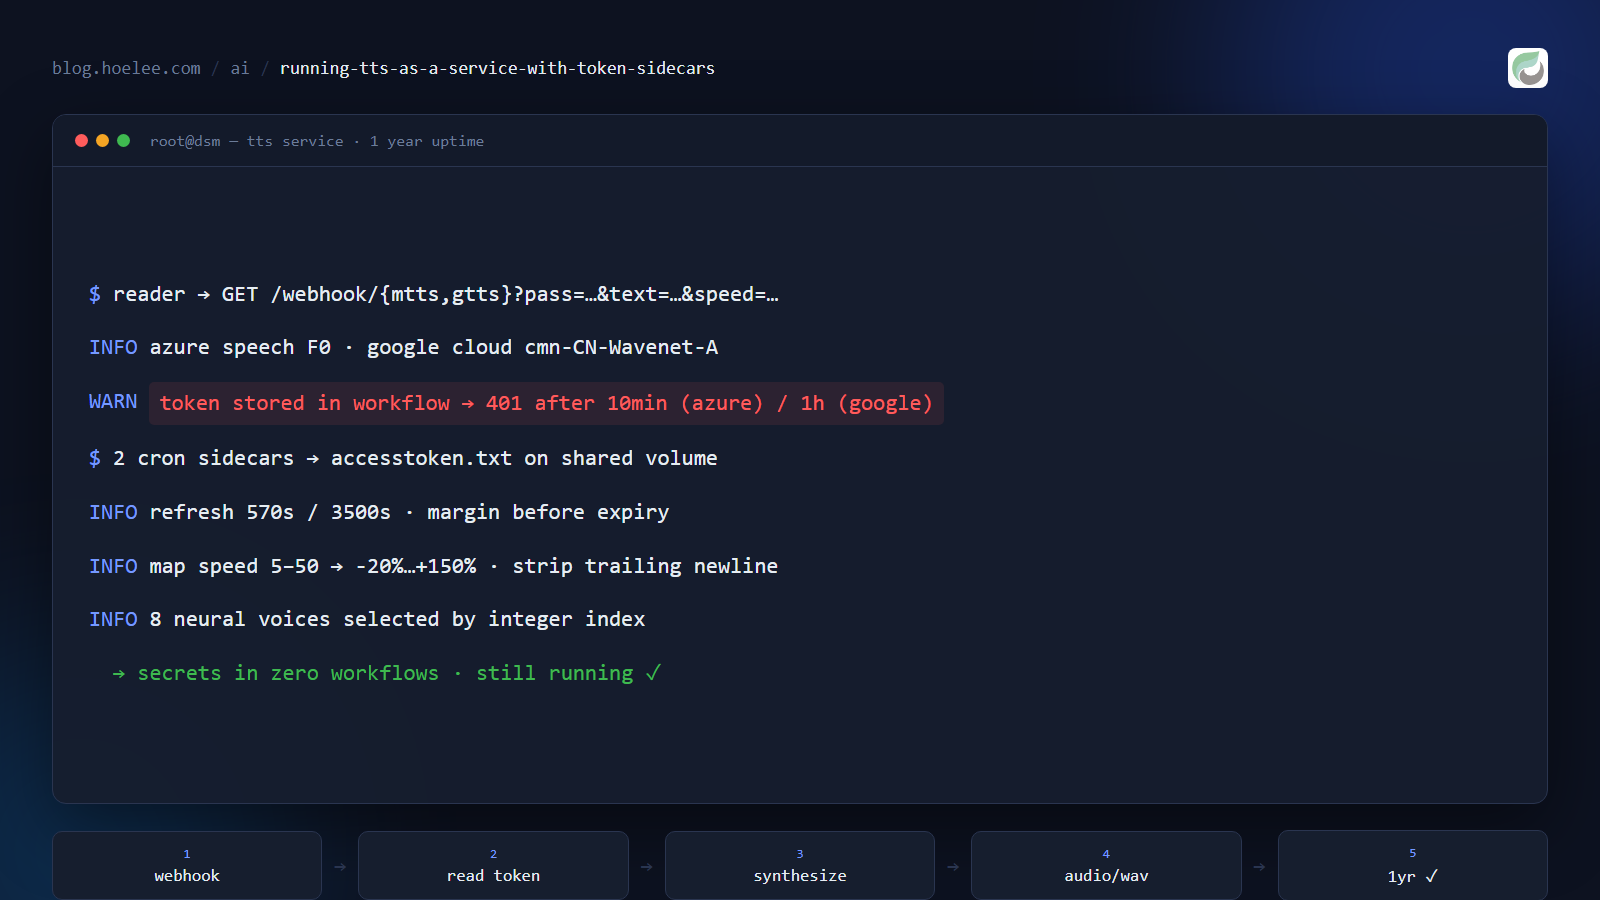
我自建了一个电子书阅读服务器。它有个「朗读」功能,内置的引擎能用但很机械。所以我把它接到了真正的神经网络语音上——Azure Speech 和 Google Cloud TTS——通过我的 n8n 实例。
那是大约一年前的事。它此后一直在运行,而且设计几乎没变过。这篇文章讲它怎么工作,更有用的是讲它为什么长成这样:整个架构的存在就是为了解决一个具体问题,而这个问题会在一小时之内击垮天真的实现方式。
为什么这件事重要
语音合成是个加进去很愉快、但维持起来出乎意料麻烦的功能。低用量下这些语音要么便宜要么免费,音质出色,API 也直截了当——直到你发现 OAuth access token 不是一种你可以直接存进配置文件的凭据。
两家服务商都会签发短期 access token,而有效期差别巨大:
- Azure Speech 免费层:大约 10 分钟。
- Google Cloud:大约 1 小时。
如果你把 token 放进一个工作流变量里,这个集成会漂亮地工作十分钟,然后开始永远返回 401。这就是那种「演示完美、生产失败」的集成的经典形状——而解法不是「记得刷新 token」,因为你不会记得。
架构:刷新 token 不是工作流的事
让这套东西能工作的设计决策,是拒绝让工作流管理凭据。取而代之,两个极小的容器独占 token 生命周期,把当前 token 写到一个共享卷上的文件里。工作流只负责读文件。
┌──────────────────┐   GET /webhook/{mtts|gtts}?pass=…&text=…&speed=…
│   阅读服务器      │ ───────────────────────────────────────────────┐
│  (httpTTS 引擎)   │                                                │
└──────────────────┘                                                ▼
                                                    ┌───────────────────────────┐
                                                    │  n8n                       │
                                                    │  ├ /mtts  (Microsoft)      │
                                                    │  └ /gtts  (Google)         │
                                                    └───────┬───────────────────┘
                                                    读取 accesstoken.txt
                                      ┌─────────────┴─────────────┐
                                      ▼                           ▼
                          Azure Speech (F0)             Google Cloud TTS
                          southeastasia 区域            cmn-CN Wavenet
                                      │                           │
                                      └──────── WAV 音频 ─────────┘
                                                    │
                                            回到播放器
两个 cron 边车容器负责保持 token 新鲜:
| 容器 | 镜像 | 间隔 | 写入 |
|---|---|---|---|
cron-azure-refresh | curlimages/curl | 每 ~570 秒 | MicrosoftTTS/accesstoken.txt |
cron-gcloud-refresh | google/cloud-sdk:slim | 每 ~3500 秒 | GoogleTTS/accesstoken.txt |
两者都 bind-mount 了同一个宿主目录,n8n 通过它的 Read/Write Files 节点读取这个目录。这个共享卷就是凭据层与工作流层之间的完整接口。
为什么间隔是这个数字:570 秒对约 600 秒的 Azure 有效期,留出 30 秒安全边际;而永远略微提前刷新,远比卡着到期点刷新稳健得多。Google 的 3500 秒对一小时是同样的道理。
cron-azure-refresh:
  image: curlimages/curl:8.10.1
  restart: unless-stopped
  volumes:
    - /volume1/docker/n8n/file:/file
  entrypoint: /bin/sh
  command: >
    -c 'while true; do
      curl -s -X POST "https://southeastasia.api.cognitive.microsoft.com/sts/v1.0/issueToken"
        -H "Ocp-Apim-Subscription-Key: $AZURE_SPEECH_KEY" > /file/MicrosoftTTS/accesstoken.txt;
      sleep 570;
    done'
为什么用文件,而不是那些显而易见的替代方案
为什么不把 token 存进 n8n 凭据、在工作流里刷新? 因为刷新逻辑就会被复制进每一个需要 token 的工作流,而每一份拷贝都需要自己的错误处理。当凌晨三点刷新失败时,你希望只有一个进程需要关心这件事。
为什么不让工作流每次请求都去调 token 接口? 可行,而且它让每次朗读请求的延迟和依赖面都翻倍。更糟的是,它意味着 token 接口的一次抖动就变成一次 TTS 故障。
那为什么用文件? 因为它是双方都已经支持的最简单接口。n8n 有内置的 Read/Write Files 节点;cron 容器可以用 curl 和 shell 重定向写入。没有队列、没有数据库表、没有共享库——只有一个内容永远是当前 token 的文件。
这笔取舍是诚实的:每次请求读一次文件,是热路径上的一次磁盘读。在一个阅读应用的请求频率下,这完全是免费的,而它换来的是凭据生命周期与请求处理之间的彻底解耦。
n8n 这一侧:两个工作流,一种形状
两个 TTS 工作流骨架相同,值得走一遍,因为细节才是有意思的地方。
1. responseMode: responseNode 的 webhook。 工作流必须返回原始音频字节而不是 JSON,所以响应由一个显式的 Respond to Webhook 节点控制,而不是 n8n 的默认行为。
2. 一道密码闸门。 一个查询参数会与期望值比对,不匹配时返回真正的 403,而不是一个空的 200:
Respond to Webhook → text: "403 unauthorized", responseCode: 403pass 值就在 URL 里,这一点我稍后会诚实交代。
3. 读取 token 文件。 Read/Write Files from Disk 读取
/home/user/file/MicrosoftTTS/accesstoken.txt。然后两个节点做清理:
Extract from File(文本模式),以及一个删掉换行的 Set 节点——因为
Authorization 头里一个尾随的 \n 会产生一个令人抓狂、且看起来完全不像空白字符问题的 401:
// Edit Fields 节点
{{ $json.data.replace(/(\r\n|\n|\r)/g, '') }}
4. 调用服务商。 对 Azure 来说,请求体是插入了语音和语速的 SSML:
<speak version='1.0' xmlns="http://www.w3.org/2001/10/synthesis"
       xmlns:mstts="http://www.w3.org/2001/mstts" xml:lang="zh-CN">
  <voice name='{{ $('Code in JavaScript').item.json.voice }}'>
    <prosody rate="{{ $('Code in JavaScript').item.json.rate }}"
             pitch="{{ $('Webhook').item.json.query.pitch }}">
      {{ $('Webhook').item.json.query.text }}
    </prosody>
  </voice>
</speak>
5. 以二进制响应返回音频,并带上正确的内容类型:
Respond to Webhook → binary, set
  Content-Type: audio/wav
  Content-Disposition: filename="output.wav"
映射问题:客户端说的是另一种语言
这个细节花的心思比 API 调用本身还多。阅读应用发送一个 speed 值,用的是它自己的刻度——5 到 50,因为那是它 UI 滑块产生的范围。Azure 想要的是百分比的 prosody rate,而 Google 想要的是一个约等于 1.0 的 speakingRate 乘数。
两家服务商的刻度都和应用的刻度不一致。所以这里有一个刻意的转换步骤,而这一步值得照抄,因为把 UI 控件映射到 API 参数是一个反复出现的琐事:
// 把阅读器的 5–50 速度滑块映射到 Azure 的 -20%…+150% 语速区间。
const inMin = 5, inMax = 50;
const outMin = -20, outMax = 150;

// 映射之前先钳制输入,这样客户端一个越界的值不会产生荒谬的 prosody rate。
if (speed < inMin) speed = inMin;
if (speed > inMax) speed = inMax;

const mapped = ((speed - inMin) / (inMax - inMin)) * (outMax - outMin) + outMin;
// → rate: `${Math.round(mapped)}%`
Google 那边则是直接相除,因为它的刻度在同一区间里接近线性:
speakingRate: speed / 25 // Google 期望约 1.0,而不是百分比两家服务商、两套单位制、一个客户端概念。把映射留在工作流里(而不是要求客户端了解 Azure 的百分比),正是让阅读应用保持服务商无关的原因——也是我能在完全不动应用的情况下加上第二个服务商的原因。
此外还有一张语音表,因为客户端发送的是整数索引而不是语音名:
const voices = [
  "zh-CN-XiaochenMultilingualNeural",  // 1
  "zh-CN-XiaoxiaoMultilingualNeural",  // 2
  // ...
  "zh-CN-XiaoshuangNeural",            // 7(女声,儿童)
  "zh-CN-XiaoyouNeural"                // 8(女声,儿童)
];
八种语音——六种成人、两种儿童——可从阅读应用 UI 选择。工作流会把索引钳制进范围,而不是信任它,这和语速钳制是同一个防御习惯。
安全方面,诚实作答
闸门是一个 pass 查询参数,比对一个固定字符串。我不打算美化它:这就是一个放在 URL 里的共享密钥。 它阻止了针对一个每次请求都要花我钱的接口的随意滥用。它阻止不了任何能读到阅读应用配置的人,也扛不住认真的攻击者。
我能接受这一点,是因为它所保护的东西。最坏的结果是有人烧掉我的免费层 TTS 配额——一件烦人事,不是数据泄露。这个接口后面没有客户数据,也没有对任何东西的特权访问。为真正的认证(OAuth、签名请求、按用户限流)付出的代价,远超这点暴露所值。
可迁移的习惯是:明确说出一道闸门属于哪一层级——这是滥用威慑,不是授权。系统出问题,往往是因为把威慑误当成了边界。如果这个接口碰到客户记录或文件访问,它就需要真正的认证——而我会从一开始就设计得不一样。
隐形成本:它被钉在一个早已过时的分支上
这项服务跑了将近一年,零代码改动。这既是好消息也是坏消息:
n8nio/n8n:1.123.72那是 TTS 文档里写明的镜像。它一直能用,所以也就没有任何东西促使我重新审视它——这正是「过于可靠」的基础设施的经典失败模式。当我终于把 n8n 升到 v2 时,这是整个技术栈里最后一处 1.x 时代的引用,而 token 刷新容器恰恰是最容易受平台行为悄悄变化影响的那部分。
教训不是「升级更勤一点」——而是:一个没有活动部件的服务,没有任何自然契机去重审它的假设。 给自己设个日历提醒去复查钉死的依赖版本,因为系统本身永远不会告诉你。
我会怎么做得不一样
- 把映射逻辑和应用一起版本化,而不是埋在某个工作流里。 语速映射和语音表编码的是阅读应用的 UI 契约。它们活在 n8n Code 节点里的 JavaScript 中,任何做应用的人在那边都看不见——而如果滑块范围哪天变了,没有任何东西会告诉我。
- 加一个真正做一次合成请求的健康检查端点。 我目前能查的只有容器起没起来。token 可以存在于文件里但依然是过期的(如果某次刷新静默失败了),而在用户撞上之前,没有便宜的办法发现这一点。
- 把钉死的版本记录在一个我真的会看的地方。
1.123.72在一个 markdown 文件里躺了一年。运维手册里加一行「复查钉死的镜像」,就能让它在下一个维护窗口浮现,而不是通过一次迁移。
结果
一年可用性、两个容器、一个共享目录,以及八种阅读应用可以用滑块选择的神经语音。请求含服务商往返在内几秒内完成,而整个东西除免费层之外零成本——因为 token 生命周期问题被一次性解决在了正确的地方。
这个模式可以泛化到任何短期凭据:别教会每一个调用方去刷新 token——跑一个唯一职责就是让某个文件保持最新的进程,让其他所有人读这个文件。 它不聪明,而这就是重点。聪明的凭据处理,正是你最后会得到四份刷新实现、其中三份是错的的原因。
需要在现有应用里接上 AI 功能?
我搭建 AI 集成里那些不性感的中层——也就是演示之后还能继续工作的那部分:token 刷新、服务商故障转移、语音与模型映射、限流处理。如果你想把语音合成、转写或 LLM 功能加进一个现有应用,并且希望它明年还能用,那就是我在做的事。
欢迎联系 [email protected] 或 WhatsApp +60 12-797 2969,也可以看看我在 hoelee.com 做什么。