为什么你的无头浏览器不是万能爬虫
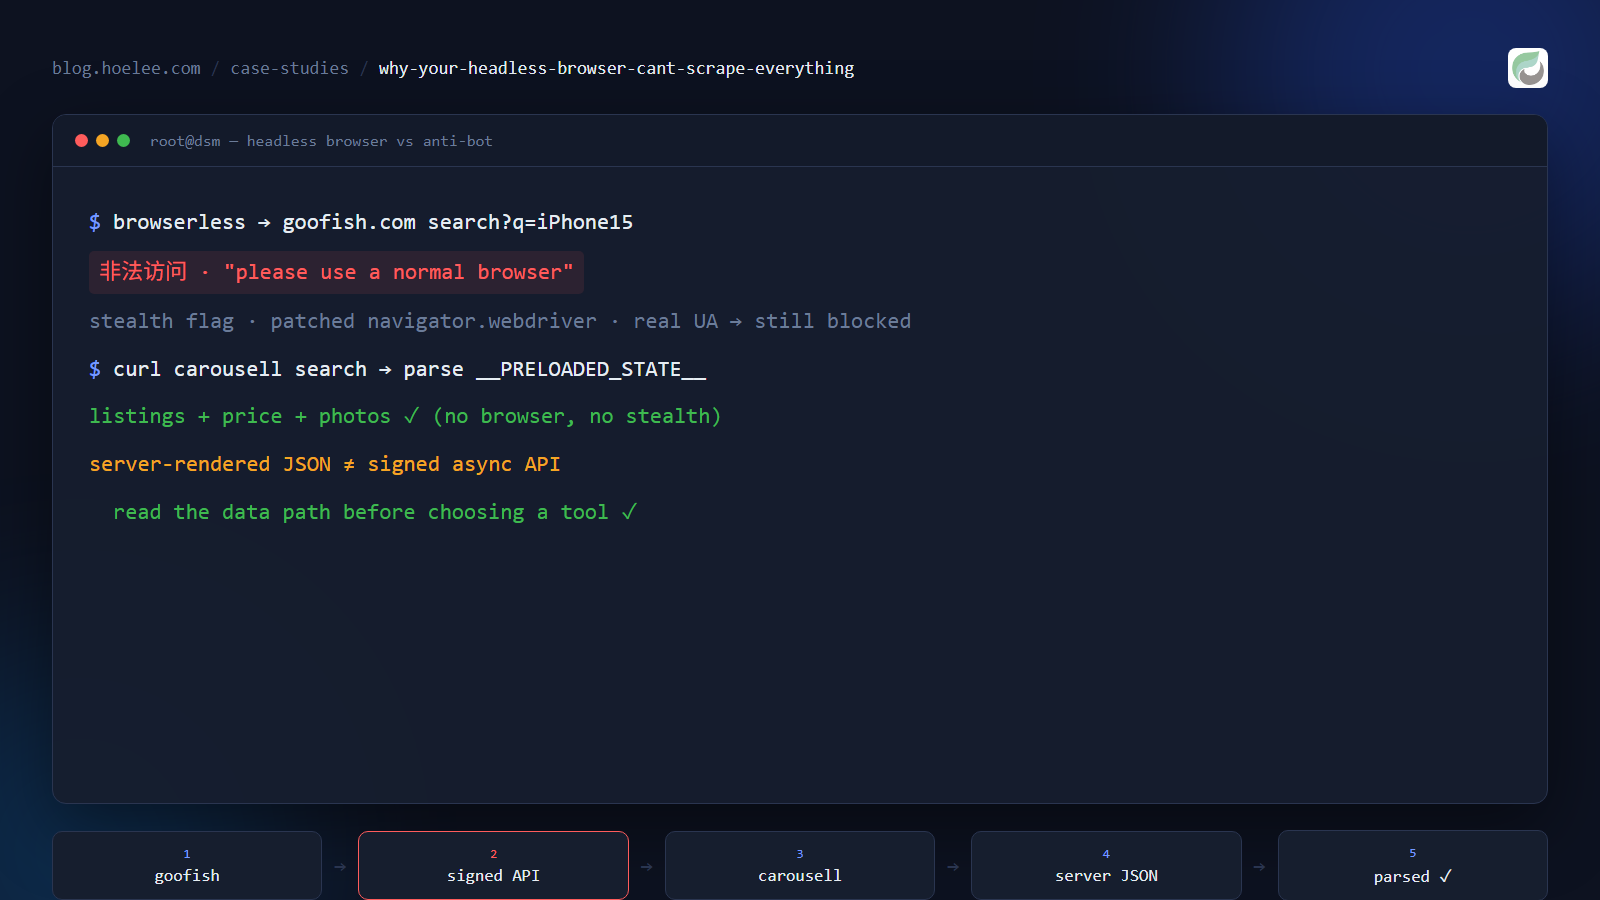
我在短短几周里,分别在两个不同的二手交易平台上撞上了同一堵墙,而这组对照 教给我的,比学一年教程还多。
在 Carousell 上,一个无头浏览器把新上架的商品连价格、成色、图片链接一起 抓进数据库——毫无问题,稳定跑了几个月。在闲鱼上,一模一样的设置,每次都 只返回同样三个词:
为了保障您的体验,请使用正常浏览器访问闲鱼~两个平台,同一个浏览器,结果完全相反。这篇文章讲的就是为什么,以及那个 本该在一开始就做、能帮我省下大半天时间的决定。
一个从一开始就没问对的问题
我想在闲鱼上搜索商品,把结果抽出来——标题、价格、链接。第一个跳出来的答案 自然是「用无头浏览器」。每个人都会这么答:用 Playwright 或 Puppeteer 把页面 渲染出来,等 JavaScript 执行完,再读 DOM。
于是我就真这么搭了。我部署了一个自托管的 browserless 容器——一个现成的
「无头 Chrome 即 API」,把它指向闲鱼的搜索页。然后我花了几个小时,把那个工具
暴露出来的每个开关都试了个遍:
--disable-blink-features=AutomationControlled隐藏自动化标志- 用
evaluateOnNewDocument把navigator.webdriver抹成undefined - 一个逼真的 Chrome user-agent
- 一个
stealth启动选项
每一次,商品列表都卡在「加载中…」——页面框架渲染出来了,页头渲染出来了, 页脚渲染出来了,但真正的商品列表永远加载不出来。返回的 HTML 里价格是 0 条, 商品链接是 0 条。
与此同时,脑子里有个声音一直在提醒我:我的 Carousell 监控器抓的也是同样的 数据,而且没有任何 stealth、没有任何反检测手段,却一直稳稳地工作。为什么?
换个思路:先看数据是怎么到页面上的
答案根本不在浏览器的那些启动参数里,而在每个网站是怎么把数据交给页面的。
Carousell 是把搜索结果嵌在页面的初始响应里的。 服务器把商品列表作为
JSON 烤进了 HTML(类似 __PRELOADED_STATE__ 这种结构)。JavaScript 之后再把
它们增强一下,但一次普通的 HTTP 请求就已经包含了所有的东西——商品 ID、标题、
价格、图片。爬虫甚至不需要渲染任何东西,直接从这个原始 HTML 里把 JSON 解析
出来就行。
闲鱼什么都不在服务端给。 它的搜索结果是在页面加载之后,才从一个带 签名的 API 端点上拉回来的。这个端点要求:
- 一个由 App 根据请求参数和一个密钥算出来的签名
- 一系列会标记无头浏览器指纹的反爬检查(WebDriver 检测、CDP 痕迹、canvas/ audio 指纹)
把签名去掉,API 就什么都不返回。把浏览器特征去掉,页面就回你一句「非法访问」。
服务端渲染的 JSON vs. 带签名的异步 API——这一个区别,就是全部的游戏。 它让你在一分钟内就判断出「用浏览器渲染」这条路是花一个下午,还是花一个月。
无头浏览器为什么在闲鱼上撞了墙
说句实在话:开源的、自托管的浏览器本身不是隐身工具。
browserless(我部署的那个容器)是个通用渲染器。它的免费版能渲染页面、
执行 JavaScript、截图、转 PDF。而反检测的能力——真正的 stealth 模式、验证码
识别、解锁代理——明确是付费的 Cloud/Enterprise 版才有的。它们文档里写得
毫不含糊。
所以说,我是在拿一个通用渲染器,去硬刚一个整个商业模式都建立在「击败自动化 客户端」之上的平台。这不是配置 bug,是工具和对手之间的错配。
真要抓闲鱼,我有几条重得多的路可选:
- 逆向 App 的签名算法,直接调搜索 API。严肃的爬虫都是这么干的——但签名 会变,所以这是持续的维护成本,不是一次性做完就完事。
- 买第三方数据接口(阿里云市场之类卖
item_search端点)。数据干净,但 按次计费,而且受制于供应商。 - 驱动一个真实登录的浏览器、低频访问,指望频率始终低于雷达线。偶尔手动 查查还行,想稳定的大规模监控,没用。
没有一条是「起个容器就能跑」的。这才是重点。
可以复用的检查清单
在给一个新目标动用 Playwright 之前,我现在会按顺序问自己三个问题:
- 数据到底存在哪里? 关掉 JavaScript 打开页面(或者直接读原始 HTML)。 如果数据就在 HTML 里,我根本不需要浏览器——我需要的是一个 HTTP 客户端和一个 解析器。浏览器纯属浪费。
- 如果不在 HTML 里,那个异步请求长什么样? 打开 DevTools → Network,找到 那个返回数据的 XHR/fetch,看它的 header 和查询参数。有没有签名?它是稳定的, 还是每个请求都变?
- 是不是带签名的 API? 如果是,停下来。先想清楚这个目标值不值得 (a) 逆向 签名,或者 (b) 付费买数据供应商。如果都不值,诚实的答案就是「这事成本高于 收益」——能在一个小时内就知道这一点,本身就是种胜利。
大多数爬虫教程会跳过这三步,直接跳到「装 Puppeteer」。那是昂贵的那条路—— 花一整天用最痛的方式,才搞懂一个 60 秒的调查早就该告诉你的事。
如果重来一次我会怎么做
- 在伸手拿浏览器之前,先禁用 JavaScript。 这是判断「服务端渲染 vs. 客户端 拉取」最快的信号,十秒钟,零配置。
- 别指望从通用渲染器里白嫖 stealth。 stealth 要么是你花钱买的产品 (browserless Cloud、ScrapingBee 之类),要么是你自己搭、自己维护的东西。它 不是一个开源容器里的勾选框。
- 把「渲染」和「提取」分开看。 无头浏览器返回的是 HTML,它不会直接给你
结构化的商品字段。就算渲染成功了,还是得有人写选择器或
evaluate脚本。那是 另一件事——要为它做计划,别以为它是免费的。
结果
这组对照沉淀成了一条我现在每个项目都会用的规则:在选工具之前,先判断目标是 服务端渲染还是 API 门槛。 在 Carousell(服务端渲染)上,一个普通的 HTTP 解析器 几个月来归档了几千条带价格和图片的商品。在闲鱼(签名 API)上,我诚实地评估了 工作量和维护成本之后选择了停下——对一个偶尔手动搜一下就够用的需求来说,这本身 就是正确的结局。
无头浏览器有时候是对的工具——截图、转 PDF、接管一个人工会话,或者目标本身 就是服务端渲染。但它不是一把通用的爬虫钥匙,把它当成钥匙,才是那个昂贵的错误。
想知道一个网站值不值得花力气去抓?
大多数爬虫项目都在第一个小时内失败,因为没人先去查一眼——这个目标到底允不 允许你用低成本抓到数据。我写代码之前会先做这个判断——我也真的在搭那些能跑起来 的监控器、通知管线,和背后的自托管基础设施。如果你盯上了一个数据源,想知道它是 一个下午的活还是一个月的活,欢迎聊聊:
- 📱 WhatsApp: +60 12-797 2969
- 📧 Email: [email protected]
- 🌐 Website: hoelee.com