我如何在自家 NAS 上自托管 Mem0 记忆栈(让 AI 助手有记忆)
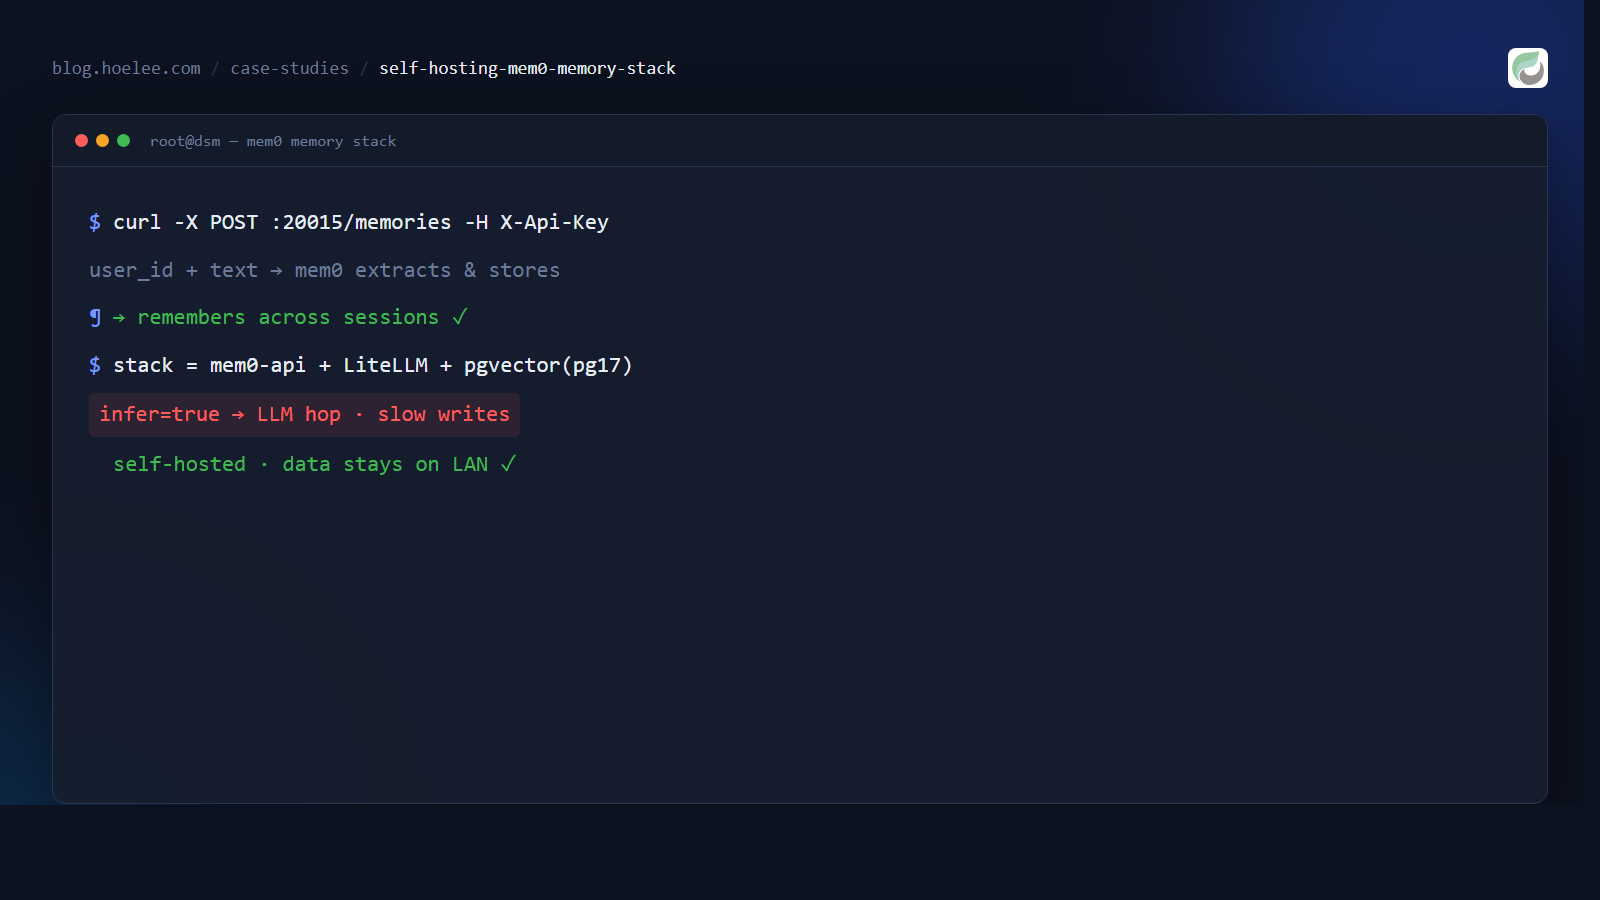
一个每次对话后都忘光一切的 AI 助手,就是一个每轮都要你重新自我介绍的工具。我的 AI 助手(就是驱动这个博客工作流的那个)曾经每场会话都从零开始——直到我给它加了一层记忆:一套自托管的 mem0 栈,负责存储它学到的事实、按语义检索、并跨会话存活。
这就是我在自家 Synology NAS 上自托管它的故事——私有、完全由我掌控、数据绝不离开我的局域网。
为什么这件事重要
记忆层改变的是一个助手真正能为企业做的事:
- 不再重复回答同样的问题。 记住客户获批的试用、他买的产品、上次的售后问题——下一段对话从上一次结束的地方继续。
- 让「个性化」成真。 一个记得客户偏好和历史记录的机器人,就是一个人。这不是提示词糖衣;这是一份存储的、可检索的记录。
- 把数据掌控权留在自己手里。 我对托管式记忆服务不满的每一点,自托管都解决了——事实存在我自己的 PostgreSQL 里、我自己的 NAS 上、我自己网络的后面。
对任何跑 AI 助手(售后机器人、研究助手、个人自动化)的人来说,问题不是助手要不要记住——而是这份记忆是一份私有资产,还是第三方的数据。
mem0 做了什么
Mem0 是给 LLM 应用用的「开箱即用的记忆」。你不用手搓嵌入表和相似度检索,它给一个小 API,把记忆需要的三件事都做了:
- 加一条记忆 ——
POST /memories传一条事实或一段对话;它抽取、去重并存储(可选由 LLM 分类)。 - 检索 ——
GET /search带一个 query,返回按语义相似度排序的相关事实。 - 按用户隔离 —— 记忆归属
user_id,所以可以按客户、按项目、按会话分开,互不串扰。
「记忆」就是抽取出来的事实;「检索」就是向量相似度。哪怕你从没亲手碰过向量数据库,也能让助手有记忆。
技术栈
Synology DS1821+ 上用 Portainer compose 栈跑三个容器:
- mem0 API —— 记忆服务本身(本地自定义构建),监听
20015端口。 - LiteLLM —— 真正做事实抽取的模型前面的 LLM 网关。不碰 mem0 配置就能换底层模型。
- PostgreSQL 17 + pgvector —— 数据库。
pgvector/pgvector把 Postgres 和向量扩展打包成一等公民,语义搜索和别的一切同库。
┌──────────────┐      /search & /memories       ┌──────────────────┐
│ AI agent /   │ ──── X-Api-Key + JSON ───────▶ │  mem0 API :20015 │
│ Hermes / bot │                                └────────┬─────────┘
└──────────────┘                                         │ pgvector
                                                         ▼
                                             PostgreSQL 17 + pgvector
┌──────────────┐     model calls (extract)    ┌──────────────────┐
│ OpenAI etc.  │ ◀───────── LiteLLM ──────────│ fact-classifier  │
└──────────────┘                              └──────────────────┘
一份有代表性的 compose 长这样:
services:
  mem0-postgres:
    image: pgvector/pgvector:pg17
    environment:
      POSTGRES_USER: mem0
      POSTGRES_PASSWORD: ${MEM0_DB_PASSWORD}
      POSTGRES_DB: mem0
    volumes:
      - ./data/pg:/var/lib/postgresql/data
    restart: unless-stopped

  mem0-litellm:
    image: ghcr.io/berriai/litellm:main-stable
    command: ["--config", "/app/config.yaml"]
    volumes:
      - ./litellm-config.yaml:/app/config.yaml
    restart: unless-stopped

  mem0-api:
    build: ./mem0-api
    environment:
      OPENAI_API_KEY: ${OPENAI_API_KEY}
      OPENAI_API_BASE: http://mem0-litellm:4000/v1   # go through the gateway
      MEM0_API_KEY: ${MEM0_API_KEY}                  # X-Api-Key for /search & /memories
      POSTGRES_URL: postgresql://mem0:${MEM0_DB_PASSWORD}@mem0-postgres/mem0
    ports:
      - "20015:8000"
    restart: unless-stopped
(我是从 mem0 仓库本地构建、把模型/事实抽取指向 LiteLLM;确切的镜像版本是我自己维护本地镜像的结果。真实 API key 我放在 compose 文件外面,走环境变量密文注入。)
使用
起起来之后,这个 API 小到意外。加一条事实(快速、逐字保存):
curl -X POST http://192.168.1.1:20015/memories \
  -H "Content-Type: application/json" \
  -H "X-Api-Key: $MEM0_API_KEY" \
  -d '{
    "user_id": "customer-2211",
    "text": "Customer 2211 prefers email over WhatsApp for order updates."
  }'
之后再取最相关的记忆:
curl -X POST http://192.168.1.1:20015/memories/search \
  -H "Content-Type: application/json" \
  -H "X-Api-Key: $MEM0_API_KEY" \
  -d '{
    "user_id": "customer-2211",
    "query": "how should I reach this customer?",
    "limit": 5
}'然后把返回的事实塞进助手回答前的系统提示词(或上下文)。这就是全部循环:存事实、召回相关的、在下一句回复里用上。
让我花了一天时间的 infer 坑
POST /memories默认infer=true会跑 LLM 事实抽取器——分类、清洗每条记忆。聪明但慢,而且每次调用都要一次模型往返。- 如果我只是想让助手逐字快速地记下某件事(客户说「请叫我 Andy」),我传
infer=false——不经过 LLM,近乎瞬时存储。
我栈上的路由是 /search 和 /memories,没有 /v1 前缀(早期一个自以为有 /v1 的包装器 404 了一阵子),认证是朴实的 X-Api-Key 头。都是小事,但都让我费过时间。
如果重来我会怎么做
- 从第一天起对常规记录就用
infer=false。 只对重要的事实跑 LLM 抽取;默认的推理模式让每一次写入都为了一句随手记付出的成本不值。 - 把 API key 当真正的机密。 它会嵌进 agent 配置和 compose 环境变量里,所以我把它从 compose 文件中拿出来,用环境密文注入。
- 把数据库放在我信任的盘上。 Mem0 的下限就是你 Postgres 的下限。我把它跑在 NAS 受保护的卷上、带备份任务——因为一个会失忆的记忆层还不如没有。
结果
一层私有、自托管的记忆,用两个小 HTTP 调用就能访问。我的助手现在跨会话记得客户、偏好和决策——而且因为整个栈都在我自己网络后面的 PostgreSQL 里,这一切都没有离开我的掌控。
如果你跑的 AI 助手动不动就忘掉上下文,自托管 mem0 是最划算、最省事的升级之一——而且你能在不把记忆送进别人数据库的前提下做到。
想让你的生意也用上带记忆的 AI 吗?
我为企业构建并自托管 AI 助手、记忆栈、网站和基础设施。如果你想让助手真正记住你的客户——或者你想聊聊雇佣我——我很乐意帮上忙:
- 📱 WhatsApp: +60 12-797 2969
- 📧 邮箱: [email protected]
- 🌐 网站: hoelee.com