Telegram 机器人通知为什么发不出去:IPv6、DNS 和一个折腾了一整天的 400
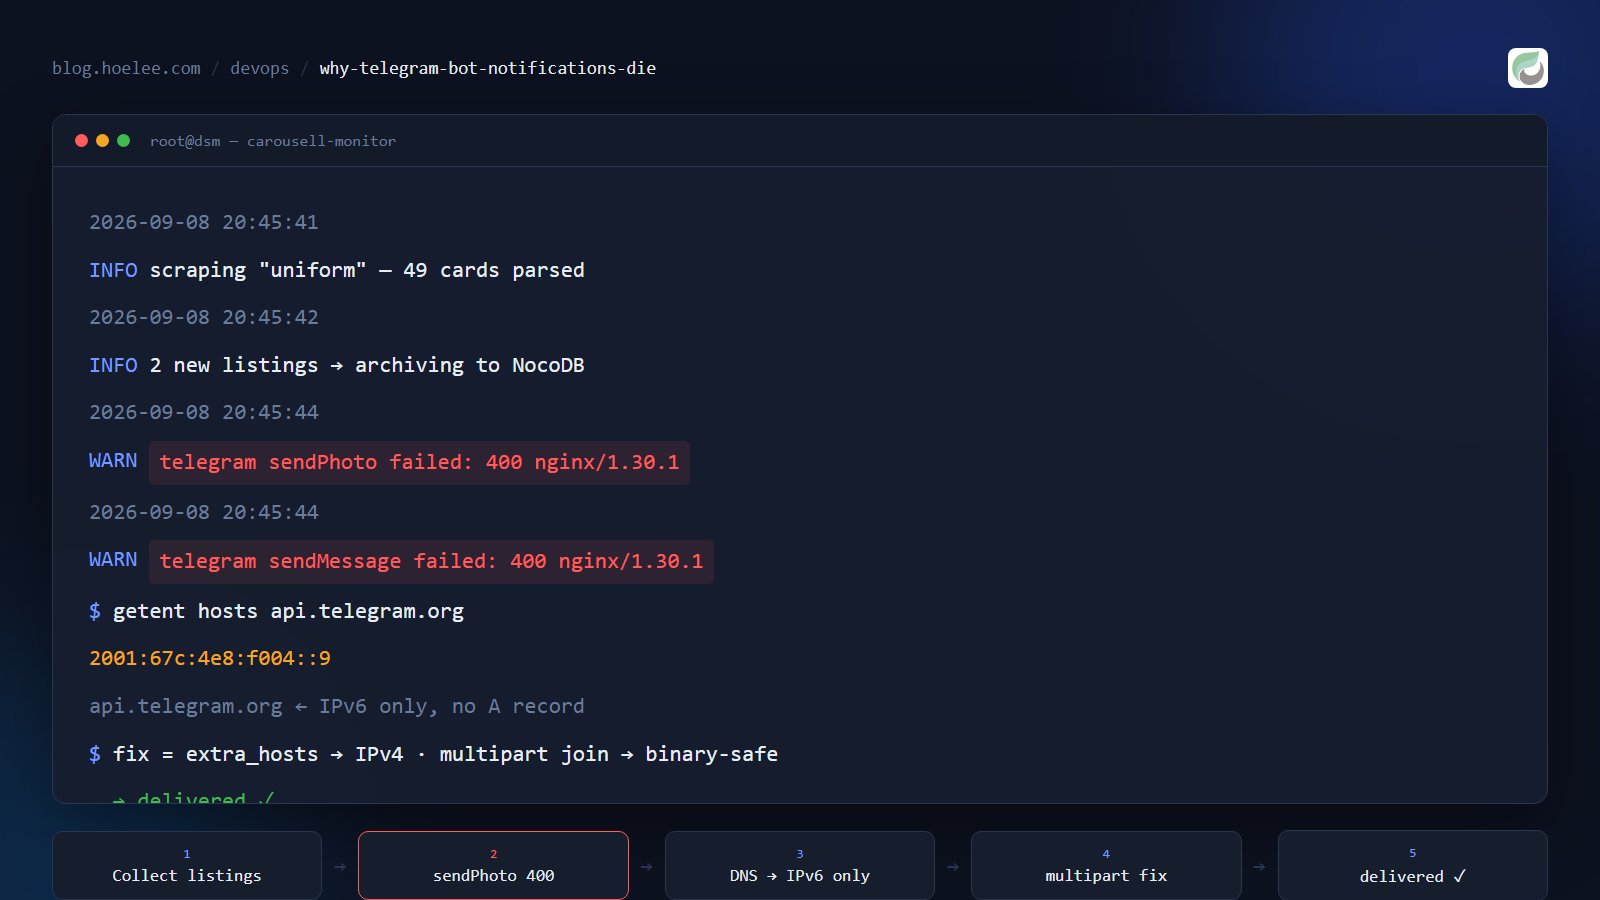
我跑着一个小监控机器人,专门盯着 Carousell 上新上架的商品,一旦有新品就通过 Telegram 通知我。有一天它突然不再通知了。容器本身是健康的,爬虫也照常往 NocoDB 里归档商品——但每一条通知都以日志里那三个字符宣告失败:
telegram sendPhoto failed: 400 ... nginx/1.30.1nginx/1.30.1 这个字符串,成了我接下来一整天排障的”反派”。这是一个看似
微不足道的 bug,实际却是由三个问题层层堆叠而成的故事——以及下一次我会
如何更快地逐个定位它们。
问题本身
这个机器人有两件事要做:采集商品,以及通知我。采集正常,通知挂了。
日志显示 400 Bad Request,并指向一个自称 nginx/1.30.1 的服务器。
我的第一反应很教科书:网络里有什么东西在拦截请求。 因为
nginx/1.30.1 这个 header 跟我印象里的 Telegram API 对不上——而且一个
带 HTML 响应体的 400(Telegram 就算出错也返回 JSON)看起来就像本地反向
代理或 VPN 网关在请求还没离开机器之前就把它拒掉了。
这种假设很省力,但也常常是错的。下面说说我到底发现了什么。
我尝试了什么,以及为什么每个都失败了
第一轮:一定是 DNS / IPv6
我先在容器里跑了 getMe——它能通。然后又跑了 sendMessage——它挂了。
同一个 token、同一个容器,一个方法通、一个方法挂。
线索藏在两个端点的解析方式里:
# 容器内部
$ getent hosts api.telegram.org
2001:67c:4e8:f004::9   api.telegram.org
容器把 api.telegram.org 解析成了只有 IPv6——一条 AAAA 记录,
没有 A 记录。而容器跑在一个 没有 IPv6 连通性的 Docker bridge
网络上。于是每个需要访问 api.telegram.org 的请求,都在试图连接一个
它根本走不到的 IPv6 地址。
修复看起来很简单:用 extra_hosts 把 IPv4 地址钉死。我照做了,DNS
应答变得完全符合预期:
149.154.167.220 api.telegram.org结果通知还是失败,同一个 400。我那得意的修复啥也没改变。
第二轮:我选错了 IP
这里有一个值得记住的教训:我是凭记忆硬编码了 149.154.167.220。
等我终于去查公共解析器时,api.telegram.org 真正的 A 记录并不是它:
149.154.166.110   api.telegram.org   # DNS 实际返回的
149.154.167.220   api.telegram.org   # 我硬编码的
167.220 确实在 Telegram 的 IP 段内(149.154.160.0/20),所以它
并不是”别人的服务器”这种错——但它不是当前活跃的端点,bot-API 的流量打到
它上面的行为是不可预测的。我把它换成 166.110,仍然失败。所以 IP 也
不是全部原因。
第三轮:同样的命令,两个相反的结果
这是整个事情开始变得诡异的一刻。在同一个容器里,几乎同一秒:
- 常驻的监控进程(
PID 1)→sendPhoto失败,400 - 一个新起的
docker exec进程跑着完全相同的代码 →sendPhoto成功,200
同一个容器、同样的代码、同样的 payload、同一秒。
我逐一排除了 token、chat_id、caption 里的 emoji、Unicode 引号、图片格式、 环境变量、以及图片 URL 本身——我把那张图下载下来测过,是一张完全合法的 JPEG。两条路径的代码没有任何差别。
当你撞上这种”输入相同、输出相反”的矛盾时,答案通常是:输入其实并不 相同。但找到那个差异,还需要我再换一次思路。
第四轮:nginx/1.30.1 就是 Telegram
我重新读了原始的 400 响应,而不是去猜。响应是一张 HTML 的
“400 Bad Request” 页面,Server 头是 nginx/1.30.1。
那个 nginx 就是 Telegram 自家的边缘服务器。 Telegram 的 API 背后就是 nginx(版本 1.30.1),当一个请求在到达它们应用层之前就已经畸形时, nginx 会自己回一张 400 页面——没有 JSON,也没有友好的错误码。
这一下彻底改变了整个视角。请求并没有被拦截,而是确实到达了 Telegram, 然后被 Telegram 的 nginx 以”畸形”为由拒绝了。
而那个畸形的东西,正是我一直没仔细看的部分:sendPhoto 的 multipart
请求体。
修复
我最初的代码是这样拼 multipart 请求体的——正是那种”看着显然没问题”、 实则埋下微妙 bug 的一行:
body = b"\r\n".join(body_lines)这个 join 看起来很省事,但 JPEG 是二进制数据。它的字节里本身就包含
\r\n 这样的字节序列,出现在图片数据中间。用 \r\n 作为分隔符去 join,
就把本该是图片 payload 的字节给破坏了。Telegram 收到的是一个 multipart
边界被破坏的请求体,于是它的 nginx 在 bot API 还没来得及解析之前就回了个
400。
正确的做法是逐字段拼装 body,让二进制数据保持原样:
boundary = "----tg" + token_hex(8)

parts = []
parts.append(f"--{boundary}\r\n".encode())
parts.append(b'Content-Disposition: form-data; name="chat_id"\r\n\r\n')
parts.append(f"{chat_id}\r\n".encode())

parts.append(f"--{boundary}\r\n".encode())
parts.append(b'Content-Disposition: form-data; name="caption"\r\n\r\n')
parts.append(f"{caption}\r\n".encode())

parts.append(f"--{boundary}\r\n".encode())
parts.append(
    b'Content-Disposition: form-data; name="photo"; '
    b'filename="image.jpg"\r\nContent-Type: image/jpeg\r\n\r\n'
)
parts.append(image_bytes)          # ← 二进制保持二进制
parts.append(b"\r\n")

parts.append(f"--{boundary}--\r\n".encode())

body = b"".join(parts)             # join 的是字节块,不是行
区别在于用 b"".join(parts) 而不是 b"\r\n".join(...):每一块本身就是
一个带完整边框的片段,我们只是把它们的字节原样拼接,而不是在
每个元素之间都插入一个分隔符。
还有一个更高层的修复值得点名:别再让 Telegram 替你去下载图片。 我 早期的代码是把图片当作 URL 传过去,让 Telegram 自己去抓:
tg("sendPhoto", {"photo": image_url, "caption": caption})这意味着 Telegram 的服务器得主动去访问源 CDN——如果那个 CDN 不稳定、 或者对 Telegram 的爬虫做了地域封锁,你就会得到本地根本无法复现的间歇性 失败。自己先把图片下载下来、再上传字节,就消除了一整类的不稳定因素, 还给了你在发送前校验字节的机会。
如果重来一次我会怎么做
- 读原始响应,而不是读假设。
nginx/1.30.1在日志里躺了好几个小时, 我却在追一个根本不存在的中间人。在凭空捏造拦截者之前,先查清楚那个 header 到底属于谁。 - 对硬编码的 IP 用实时解析器验证。 记忆不是 DNS。
dig +short api.telegram.org只要三秒钟,就能省掉我整整一轮。 - 把”输入相同、输出相反”当成谎言。 输入从来就不相同——两个进程在某 个我没看到的地方有差异。诚实的做法是去 diff 字节,而不是 diff 代码。
- 永远不要用文本分隔符去手工拼接二进制数据。 把文本和 JPEG 混在一起
做
b"\r\n".join(),迟早会出破坏 bug。
结果
multipart 修复之后,监控机器人在下一个 tick 就真正把通知发出去了—— 图片和文字都在。我还一并加了一个重试队列:一条失败的通知会保持”未发送” 状态,30 秒后自动重试,而不是悄无声息地消失。整件事耗掉了大半天的功夫, 但它变成了那种我这辈子不会再踩第二次的坑。
这个机器人是我个人的项目,但教训可以推广到任何依赖外发通知的服务。如果你 有一个监控、抓取,或者需要可靠地触达用户的告警管线,我们可以聊聊。
我搭建可靠的监控与通知管线——Telegram/WhatsApp 告警、抓取器,以及背后的 基础设施。 告诉我你要监控什么、通知要发到哪里: