我把工具站 46,777 个请求过了一遍:部署检查是真人访问的 70 倍

为什么这件事值得写
我给小商家维护的那个工具站——36 个纯浏览器工具,管税、报价单、电子发票、二维码和图片——对外有一个写起来很容易、守起来很贵的承诺:什么都不上传。没有后端、没有 API 调用、没有分析、没有 cookie、没有第三方主机。构建里有一道叫 audit-dist 的闸门,会走一遍产物,只要里面出现任何外部主机名,构建就失败。
这个承诺是有账单的,账单就是:站点回答不了一个业务上最基础的问题——有人来过吗?没有埋点可读,没有会话表,没有面板。存在的只有那个站点唯一一个容器里的 nginx access log,以及一件我很清楚的事:从这里算出来的任何东西都必须算得很小心,因为只有一次机会,也没有第二个数据源可以互相印证。
下面就是这次测量的记录,按它出错的顺序写:那个承诺、那份日志、我拿到又不得不丢掉的两个数字、把噪声剥掉之后剩下的 202 个请求,以及我为还没来的访客先做好的那部分转化路径。
这篇文章里的每一个数字都从一次减法开始。日志里 46,777 个请求,其中 26,224 个是静态资源——JS 分块、CSS、图片、字体——减完剩下 20,553 个非资源请求。从这一段往下,说的都是这 20,553 个。
一个禁止测量的承诺
“不上传”这个设计有真实的商业理由,跟洁癖无关。一个马来西亚中小企业要把报价单做成 PDF,或者检查一个身份证号结构对不对,它并不想把文件、员工名单、薪资数字送到陌生人的服务器上,而且这种事常常没法写进一份合规文档里说清楚。把活儿放在访客自己的浏览器里做,就不存在“数据处理”这个问题要回答。站点 sitemap 里的 186 个 URL——36 个工具乘英文、/ms/ 马来文、/zh/ 中文三个语种——全部建立在这个基础上。
代价落在我这边:这篇文章里每一个数字都来自一份日志。没有 JS 标签可以确认它,没有分群可以对照,也没有办法下个月换一个定义重算一遍,然后把差值叫作“洞察”。
数字只能从哪里来
站点跑在一个容器里,tools-web,镜像 nginx:1.29-alpine,在我的 Synology NAS 上。那台机器 SSH 拒密钥,所以进去的路是 Portainer API:找到容器,然后向 Docker 要它自己的日志库——nginx 的 access log 是写到 stdout 的,保存它的是 Docker。一次只读 GET,回来四万八千行,宿主机上不用装任何东西。
测量的窗口是 2026-11-06 09:41Z 到 2026-11-12 23:51Z,共 6.6 天,下面说的全是这个窗口里 20,553 个非资源请求。每一个数字都是请求数,不是访客数、不是会话数。请求数是这份日志唯一能诚实给出的单位,因为站点不设 cookie,也就没有办法把两个请求拼成一个人。
第一个错数:11,930 个“人”
第一版分类器是最直觉的那版:去掉静态资源,再去掉 user-agent 看着像爬虫的,剩下的算人。它报出 11,930 个“人”。
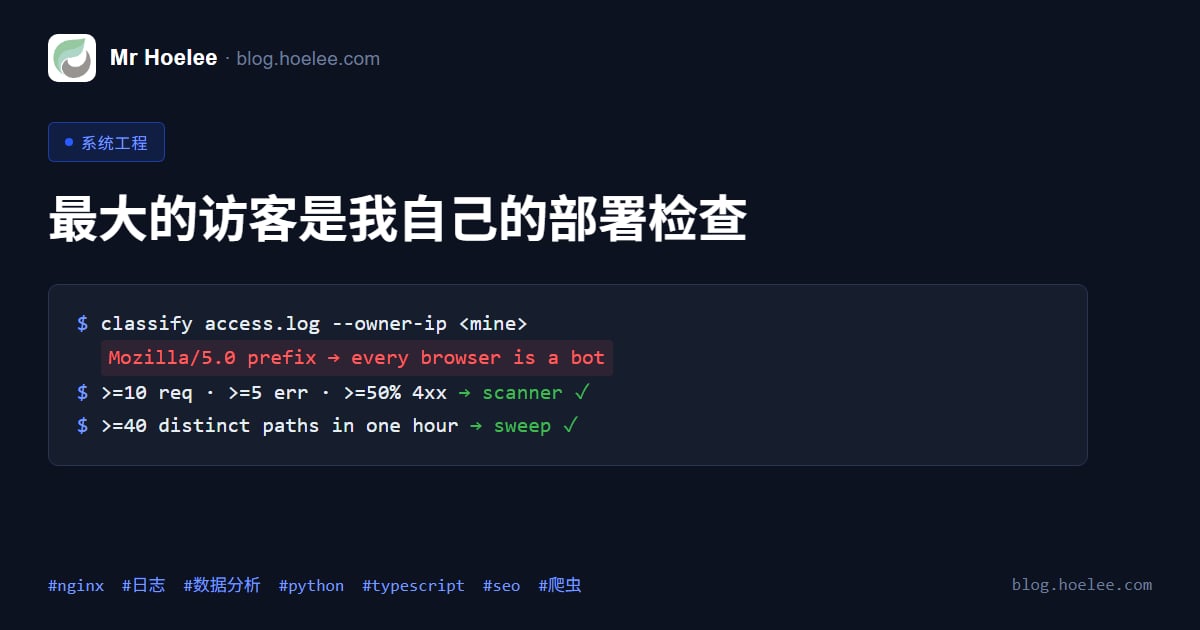
这 11,930 个全是我自己。每次部署之后有一个叫 live_check.py 的脚本会走完 sitemap 里全部 186 条路由,再加一组 headless Chrome 探针,它发出的 user-agent 是 hoelee-tools-live-check。我那张过滤器里写着 Googlebot、bingbot 之类的爬虫名单,自己的工具不在名单上,于是这个站点最大的一股流量被客客气气地算成了读者。破绽在数字里,不在代码里:11,930 太接近 186 条路由乘以一周里的部署与重试次数,而且没有哪个小站会有上万个访客却只有三个外链来源。
第二个错数:3,750
第二版把自家工具加进了爬虫名单,报出 3,750 个“人”。这一版错得更有意思:里面全是跑在 Google Cloud 地址上、UA 写得像普通 Chrome 的扫描器。最大的那一个发了 1,172 个请求,其中 1,140 个是 404,请求的全是 /.env 的各种变体——这是找泄露凭据文件的动作,只是穿了一件浏览器外套。
一个例子就把 user-agent 的全部问题摆清楚了:这个字符串是客户端自己写的,所以一个想装成访客的脚本,写的东西和一个访客的浏览器写的一模一样。我想分开的那两个类别,是同一个人写的。
只剩 6 个人的那一版
倒数第二版是值得认下来的那一版。我把 Mozilla/5.0 当成爬虫前缀加了进去,因为太多爬虫的 UA 以它开头。所有真实浏览器也以它开头。人数据塌到 6,而 6 这个数字终于让我停止改名单,去看名单本身在做什么。
靠加名字修不好一个 user-agent 过滤器,因为两个方向的错误是相反的:每加一个名字去抓说谎的,就会连带抓住共用同一前缀的诚实客户端;每减一个名字去保护真浏览器,就会放一个扫描器进来。我写的这个分类器,准确性取决于一个由对手控制的字段。
日志里实际有什么
最后上线的版本分成几遍走,并且把每个有疑问的客户端放进一个有名字的桶里,而不是删掉。20,553 个非资源请求的分布是:
| 桶 | 请求数 | 占比 |
|---|---|---|
我自己的部署后检查(live_check.py 与 headless 探针) | 14,228 | 69.2% |
| 披着浏览器 UA 的云端扫描器 | 2,298 | 11.2% |
| 声明自己是爬虫的,以及链接预览抓取器 | 1,883 | 9.2% |
| 我自己家的 WAN 地址 | 1,250 | 6.1% |
找凭据的(/.env、/.git/config、/xmlrpc.php、wp-login) | 692 | 3.4% |
| 剩下的,分散在 101 个地址 | 202 | 1.0% |
标题里那个倍数来自第一行和最后一行:我自己部署检查的 14,228 个请求,对其他人加起来 202 个——部署检查是真人访问的 70 倍。这句话两边数的都是请求,不是人;它说明的与其说是互联网,不如说是我的工具链:这个站点带宽最大的消费者,是我写来确认站点正常工作的那个脚本。
这个 70 也值得拿日志里最大的那个诚实数字压一压,因为读的人完全可以说分子是我自己造的、比法是挑出来的。把机器的桶全加起来——14,228 + 2,298 + 1,883 + 692 = 19,101——日志里就是 19,101 个机器请求对那 202 个,94.5 倍。两个倍数都写在这篇里是有意的:94.5 倍是全部机器流量和“可能是人”之间的距离,70 倍只是更窄的一句——我自己的部署检查单独一项就多过人的残留。70 是这两个数里更小的那个,不是更好看的那个。
是行为抓到了扫描器,不是 UA
真正起作用的做法是丢掉“这是谁”这个问题,改问“形状长什么样”。一个客户端的判定条件是:至少 10 个请求,并且满足下面之一——至少 5 个错误且其中 4xx 占比不低于一半,或者一小时内请求了至少 40 个不同路径。后一条抓的是枚举式扫站,前一条抓的是反复要不存在的东西。
const MIN_REQUESTS = 10;
const MIN_ERRORS = 5;
const ERROR_SHARE = 0.5;
const DISTINCT_PATHS_PER_HOUR = 40;

// 每个地址每小时一行。整周的总数从不参与判定。
function isScanner(bucket: { requests: number; errors: number; paths: Set<string> }) {
  if (bucket.requests < MIN_REQUESTS) return false;
  const errorBurst =
    bucket.errors >= MIN_ERRORS && bucket.errors / bucket.requests >= ERROR_SHARE;
  const pathSweep = bucket.paths.size >= DISTINCT_PATHS_PER_HOUR;
  return errorBurst || pathSweep;
}
一个渲染型爬虫一小时抓 60 个真实页面,会碰到 60 个不同路径——如果阈值是 60,它就会被判成扫描器。所以阈值是每小时 40 条,而且爬虫是单独一个桶、只报数、从不减掉。完整的两遍分类器、阈值和解析代码留在工具站的仓库里,没有搬进这篇,因为方法是可复用的,而这篇写的是它测出了什么。
站主自己是一个桶,不是一个减法
我自己的地址通过一个显式的 --owner-ip 参数传进来,被算进输出里单独一行(这个窗口里是 1,250 个请求),和其他行一起打印。它从来不会被悄悄删掉。这听着像记账,实际上是“测量”和“故事”的分界线:一个偷偷把运营者流量删掉的分类器,想让剩下多少就是多少,而读的人没有办法核对算术。六个桶加起来等于原始的非资源总数,这个可以手算核对;加不起来,就是分类器坏了,我能看见。
任何提交进仓库的文件里都没有 IP 地址,输出只有聚合计数。理由不是小心翼翼的洁癖:日志是访客唯一可能被识别的地方,而一条让访客去打开 WhatsApp 的路径,不需要知道他在打开之前是谁。
这个数字还错在哪里
六个桶能加起来只说明可核对,不说明正确。202 里还留着三处缺陷,而且方向一致,都是往我这边偏。
十四个资源请求被当成页面。/assets/ 下面最后一段没有可识别扩展名的请求——哈希命名的 chunk 不带后缀、字体带查询串——会落进真人桶,因为区分页面与资源的依据就是扩展名,而没有东西可判。它们不是人,是同一次页面加载被算了第二遍。
十三条扫描路径绕过了凭据正则。//phpmyadmin、/PHPMyAdmin/index.php、百分号编码的 %2eenv,和 /.env 是同一个猎捕动作,只是换了写法去绕开大小写敏感的匹配,却被当成真人页面请求计进去。
站主桶绑在一个静态地址上。这个窗口里它是对的,因为地址确实没变,但论证落在的是一个数值上,而不是一条规则上:运营商级 NAT 后面的光纤线路早晚会换地址,换的那天,1,250 个请求就离开站主那一行,走进新地址落到的任意一个桶,而分类器不会给我任何提示。
三处缺陷里有两处可以从日志本身数出来——这才是它们该写进文章的理由。202 个请求里有 14 个要的是 /assets/ 下的路径(同一张图被要了十三次,另有一串畸形的 srcset 整段当成了一个路径),另有 15 个回来的不是 200:十四个 404 加一个 301,其中好几个是太小、没触发扫描阈值的凭据试探(/dev/.env、/media../.env、/appsettings.json、/gcp-credentials.json、/service-account.json、//wordpress/、/wp-json/)。
所以「是页面、而且回了 200」的请求是 187 个,不是 202,比例不是崩掉而是重算:14,228 / 187 = 76×、19,101 / 187 = 102×。把这笔算术摆出来,正是把三处缺陷写出来的目的:能吸收自身误差棒的比例是测量,吸收不了的是主张。
三个外链来源,全是 google.com,没有一个来自搜索结果
整整 6.6 天里,日志记录的外部来源只有三个,全部来自 google.com。没有一个访客是从搜索结果页进来的。工具站是被索引的,页面是有用的,而按唯一能拿到的证据看,没有人是通过搜索找到它的。
这个发现重新安排了后面的工作。花在“转化”上的每一个小时,都花在一个几乎没有输入量的环节上。这个站点的问题无论是什么,都在工具页面的上游。
爬虫学会渲染了
日志里最有用的信号是那个在长的。Google 的渲染爬虫在有计数的几天里抓了工具页:2026-11-08 抓了 11 个页面,11-10 抓了 44 个,11-11 抓了 16 个,11-12 抓了 60 个。它在 11-12 的最后几次抓取发生在 22:12Z 到 22:39Z 之间,抓的是 /qr-code-generator/、/whatsapp-link-builder/、/ms/pemotong-gambar/,接着抓了这些页面加载的 JS 分块(store-zip、exif)。一个会去抓页面运行所需的那个分块的爬虫,是在渲染页面,不是只读一下 robots.txt。
这里要说准确它意味着什么、不意味着什么。抓取不等于索引。 抓到只能证明页面被取回并执行了,不能证明它被收录,更不能证明它有排名。同一周的外链来源——三个、全是 google.com、没有一个来自结果页——就是“被抓到”还没有变成“被找到”的证据。
那个 404 是我自己的
几乎所有看起来合理的 404 都是找凭据的,在探一个这个站点从来没有过的 WordPress 或 Laravel 目录结构:/.env、/.git/config、/xmlrpc.php、wp-login。这些是噪声,现在分类器给它们贴了标签。
有一个 404 是真的。有入站流量打到 /myKad-parser,大写 K。路由是小写的——/mykad-parser/——所以大写 K 就是 404,这是这一周唯一一个真正坏掉的入站链接。日志只告诉我这个请求发生过,不告诉我链接长在哪儿,所以我知道它存在,还没看见它。
没人检查过的那个 sitemap 文件名
/sitemap.xml 是手写的:186 个 URL,每个 URL 四条 xhtml:link 备用链接,对应英文、马来文、中文三个版本。手写的原因是 @astrojs/sitemap 在不同语种 slug 不一致时会丢掉马来文,而这里就是不一致。
手写 sitemap 修好了内容,留下了文件名。日志里能看到爬虫在请求 /sitemap-index.xml 和 /sitemap_index.xml——Astro 自己的集成和大多数爬虫最先猜的名字——拿到 404,然后就不继续了。停在那个 404 上的客户端包括 DeepSeekBot、KimiBot、MoonshotBot、cohere-ai、Hunyuan、PerplexityBot、ExaSearchBot、IsonSearchBot、MJ12bot、ccrawl 和 AgentRegistryCrawler。找不到 sitemap 的爬虫不一定什么都不抓,但它不再系统地抓;对一个没有任何入站链接的站点来说,那就是发现预算的大半。
上线的修法很小,而且故意很无聊:/sitemap-index.xml 现在是一个只有一条记录的 sitemap index,指向 /sitemap.xml。sitemap 规范允许 sitemapindex 引用 sitemap,所以这是合规写法而不是花招。它不带 <lastmod>,因为真 sitemap 里的日期是合成的、稳定的——取它们的最大值,等于把同一个虚构再写一遍到第二个地方,而相信它的爬虫就是在相信同一份猜测的两个副本。
现在有构建闸门:别名缺失、不是 sitemapindex、或者引用了不止那一份 sitemap,构建就失败。最后一条最重要:把页面清单复制进别名里,就造出了第二个没人校验的事实来源,而两者第一次漂移的那天,站点就会对外提供一份自相矛盾的 sitemap。
为还没来的访客先做的那部分
外链来源说瓶颈在分发。70:1 的比值说日志被我自己的流量占满。这两件事都不是“先什么都别做”的理由,所以同一天我做了漏斗里不依赖流量大小的那一半——决定一个人用完工具之后发生什么的那一半。
36 个工具页里的 26 个,现在在下载按钮下面收一个安静的块。三句话:刚做出来的那个东西的手工上限、一个成长中的业务会超出它的那个永久运行状态、以及一个关于他现在怎么做的开放问题。下面是一条 ghost 链接,点开 WhatsApp,消息已经写好了。
那条消息是静态的,这是有技术原因的设计决定。wa.me/?text= 是一次跳转:链接被点开的那一刻,文本就已经在 WhatsApp 服务器的 URL 里了,不管有没有人按下发送。我的第一版草稿把报价工具里访客自己的合计金额插进了链接,想让消息一打开就是“我的报价是 RM X”。那份草稿被我自己否掉了,原因就是这个:数字在任何人按发送之前就已经离开浏览器了,而这正是整个站点承诺不做的那一件事。
消息里唯一可变的部分是页面 slug,而它就是归因:我在对话里读到的第一行是 — from tools.hoelee.com/quotation-pdf。一个没有分析的站点就是这样报告哪一页带来了对话的。它比漏斗报表差,但它是诚实的数据——在访客知情的前提下,在他选择联系的那一刻收集的。
有 10 个工具完全没有商业块。 对一个真正的下一步是法定申报的访客——KWSP、PERKESO、LHDN、JTKSM、SSM——诚实的收尾不是推销。这十个是:薪资、印花税、加班、SSM 校验、SST、身份证、MyKad 解析,加上三个电子发票工具。每一个的理由都写在源码里它 slug 的旁边,下一个动这个文件的人不用再重建一遍判断。
同一天还删掉的是一条通用的表单横幅,它原来压在每一个工具页上。在那 26 个页面上,它把内容重复了一遍,还在下载旁边放了一个主按钮,跟这个页面存在的唯一动作抢位置。在那 10 个法定页面上,它就在一次税务拒绝的正下方卖网站设计——我上线过的最糟糕的广告位置。
结果
- 6.6 天 46,777 个请求,其中 20,553 个不是资源,202 个有可能是人,分散在 101 个地址上。
- 14,228 个请求是我自己的部署检查:是全人类那一块的 70 倍,占全部非资源流量的 69.2%。
- 机器请求合计 19,101 个——14,228 + 2,298 + 1,883 + 692——是那 202 个的 94.5 倍。如果有人嫌部署检查这项是我自己造成的,就报这个数。
- 三个外链来源,全是 google.com,没有一个来自搜索——这就是“瓶颈在分发”这个结论的实测依据。
- 有计数的四天里,Google 渲染爬虫抓了 131 个页面(11、44、16、60),最后落在真实工具页和它们的 JS 分块上。是抓取,不是索引。
- 36 个工具页里 26 个带静态消息的 WhatsApp 块,只用 slug 归因;10 个什么都不带,每一个都有写下来的理由。
- 上线并加了闸门的 sitemap 别名一个;找到、还没修掉的坏入站链接一个(
/myKad-parser)。
我说不出来的,是那个块的转化率,因为要量它就得有埋点,而这个站点存在的意义之一就是没有埋点。第一次诚实的读数会是那些对话本身,以及每段对话第一行里的 slug。
我会改的地方
先按行为分类,user-agent 只用来给已经被行为分开的桶贴标签。我那两个错数都来自相信那个字符串,而第二个错得还很讨喜——三千多个“人”,其实是一个拿着 .env 路径清单的扫描器。
第二:把自己的流量做成一个有名字的桶,并把桶打印出来,让它们加起来对得上。数字一开始不平衡,我找到的是分类器的 bug,而不是故事里的 bug。
第三:先检查爬虫会猜的那些 URL,再问为什么没被收录。/sitemap-index.xml 的成本是一行 nginx 配置或者 public/ 里的一个文件,而十一种爬虫一直在问。这是能拿到的最便宜的发现性修复,它一直没上,跟“手写 sitemap”存在的时间一样长。
最后一条是关于力气往哪放的判断。漏斗那部分值得做,我也会再做一次,但它不是那个约束。一个只有 202 个可能访客和三个外链来源的站点,问题不在转化;这个站点接下来一个月的工作,应该在工具页面的上游。
想要一个 24/7 自动接单、发试用、不漏单的业务自动化系统?
别让夜间和周末的客户询盘因为“没人回”而流失给竞争对手。我帮中小企业定制 Telegram / WhatsApp 智能客服与全自动履约系统(打通商品库、CRM 与自动发货,无高昂 SaaS 人头费)。