自建语音转文字服务:打字速度的五倍,而且数据不出内网
打字的办公效率里面,它是最慢的一环。一般人打字速度约每分钟 40 个字,但 说话是 130 字。每一封邮件、每一份报价、每一份报告、每一次客服回复、每一 条聊天消息,公司都在为这个差距付税——而付税的人通常是键盘打得最快的那个。
语音转文字可以把这个税省掉。但多数人采用的那套方案有两个问题:按人头收月费, 而且把你的声音——内部讨论、客户姓名、报价、合约内容——全部送到别人的云端。
所以我做了另一个版本:**一台办公室里的普通电脑,用它自己的 GPU,跑起一套 语音转文字 API。**我的开发电脑、iPhone、iPad、Android 手机都通过它来语音输入。 比打字快,不限量,而且没有任何数据离开我的内网。
以下是怎么做的——包括花掉我大半天时间的四个坑。
为什么值得做
语音转文字是办公自动化里杠杆最高、却又最不花哨的一环。具体来说,自建方案能给 你这些东西:
- **大约是打字的 5 倍吞吐量。**说话 130 wpm 对比打字约 40 wpm,口述一封 500 字 的邮件大约是说 4 分钟,而不是打 12 分钟。一天写 10 封邮件的人,每天省下一 小时。
- **成本跟着硬件走,不跟人头走。**云端听写是按用户按月收费,而且一直收。这套 跑在你自己买的机器上。加到第 10 个员工,边际成本是零。
- **不限长度,没有额度的焦虑。**没有分钟数上限,不会在星期五下午四点跳出来 说”你已用完本月额度”。
- **你的音频还是你的。**医疗记录、法律草稿、人事对话、客户报价——语音天生 就是敏感数据。自建意味着转写内容不会离开公司。
- **在任何已经获得焦点的程序里都能用。**不是那种”先转写、再复制粘贴”的网页 工具,而是可以直接在 Outlook、WhatsApp Web、CRM 或你自家内部系统里用的 输入键盘。
如果你公司里有一群人整天在写字,这件事的意义跟当年从拨号换到宽带是同一个 量级——而且它花的只是一张你可能早就有的显卡。
需要准备什么
| 部件 | 我用的是 | 说明 |
|---|---|---|
| GPU 电脑 | RTX 3060(12 GB)的台式机 | 任何显存 ≥6 GB 的 NVIDIA 显卡都行,可以就是一台普通办公电脑 |
| 转写引擎 | whisper.cpp + CUDA | 开源免费 |
| 模型 | large-v3(约 2.9 GB) | 准确率最好;小模型占显存更少 |
| 分发层 | n8n + nginx 网关 | 加上认证,端点才能安全共享 |
| 客户端 | 桌面程序、iPhone、iPad、Android | 任何支持 OpenAI 转写 API 的客户端 |
这台电脑不必专用。我的同时还在做开发、跑本地大模型推理和图像生成——模型在 有请求时加载、空闲时卸载,所以它不会长期占着显存。
整体架构
最重要的设计决定是:**手机从来不直接连 GPU。**中间有一个看门人负责认证,GPU 本身一直待在私有网络里。
   iPhone / iPad / Android / 办公电脑
                 │
                 │  HTTPS + 每台设备独立的 API key
                 ▼
     ┌───────────────────────────┐
     │  https://stt.example.com  │   公网 HTTPS 入口
     │  reverse proxy            │
     └─────────────┬─────────────┘
                   ▼
     ┌───────────────────────────┐
     │  nginx 网关容器            │   转发认证头,固定路由
     └─────────────┬─────────────┘
                   ▼
     ┌───────────────────────────┐
     │  n8n 工作流                │   校验 key,不符返回 401/403
     │  (音频永不落库)           │
     └─────────────┬─────────────┘
                   ▼
     ┌───────────────────────────┐
     │  PC 上的 whisper.cpp      │   GPU 转写
     │  :20129  →  {"text": …}   │
     └───────────────────────────┘
四层,每层只做一件事:代理终结 TLS,网关修好路由,n8n 负责授权,whisper 负责
转写。最终对外是 POST /v1/audio/transcriptions——跟 OpenAI 同一个形状,所以
任何 OpenAI 兼容的客户端都能零改动接上。
开始动手
whisper 需要 CUDA 和 CMake 工具链。在 Windows 上就是装三样东西然后编译:
git clone https://github.com/ggerganov/whisper.cpp
cd whisper.cpp
cmake -B build -DGGML_CUDA=ON -DCMAKE_CUDA_ARCHITECTURES=86
cmake --build build --config Release -j
然后取模型并启动:
# large-v3, ~2.9 GB
cd models && sh ./download-ggml-model.sh large-v3 && cd ..
./build/bin/Release/whisper-server.exe \
  -m models/ggml-large-v3.bin \
  --host 0.0.0.0 --port 20129 \
  --convert
--convert 比看上去重要:有了它,服务可以接受 MP3 等压缩格式(内部调用
ffmpeg 转码),而不是逼每个客户端都发原始 WAV。多数手机 App 发的都是压缩音频。
到这里服务已经是一个可以用的转写 API 了。后面所有的工作,都是让它能够安全地 从手机访问。
坑一:CUDA Toolkit 装了一个不完整的编译器
CUDA Toolkit 安装程序的默认组件里包含 nvcc——但不包含 nvcc 真正编译时
需要的那些部件。我前两次 CMake 都因为缺头文件失败,而错误信息指向的是我的
编译配置,不是一个残缺的工具链。
解决办法是把三个组件显式勾上:
crt_13.x      → C 运行时头文件(缺的就是 <crt/host_config.h>)
nvvm_13.x     → 里面有 cicc,才是真正的 CUDA 编译器后端
cublas_13.x → cuBLAS,运行时链接需要要留意的症状:nvcc --version 能正常输出,但编译立刻因为缺头文件挂掉。
能跑的 nvcc 不等于装好的工具链。
坑二:它只监听 localhost,防火墙是无辜的
whisper 默认绑定 127.0.0.1——只有本机回环。不管防火墙怎么设,网络上的其他
设备都到不了。
我在这里浪费了不少时间,因为我认定是防火墙问题,反复测防火墙(甚至整个关掉), 而真正的原因在绑定地址上。loopback-only 在定义上就拒绝所有其他网卡。
# 端口活着但没对外暴露时,长这样
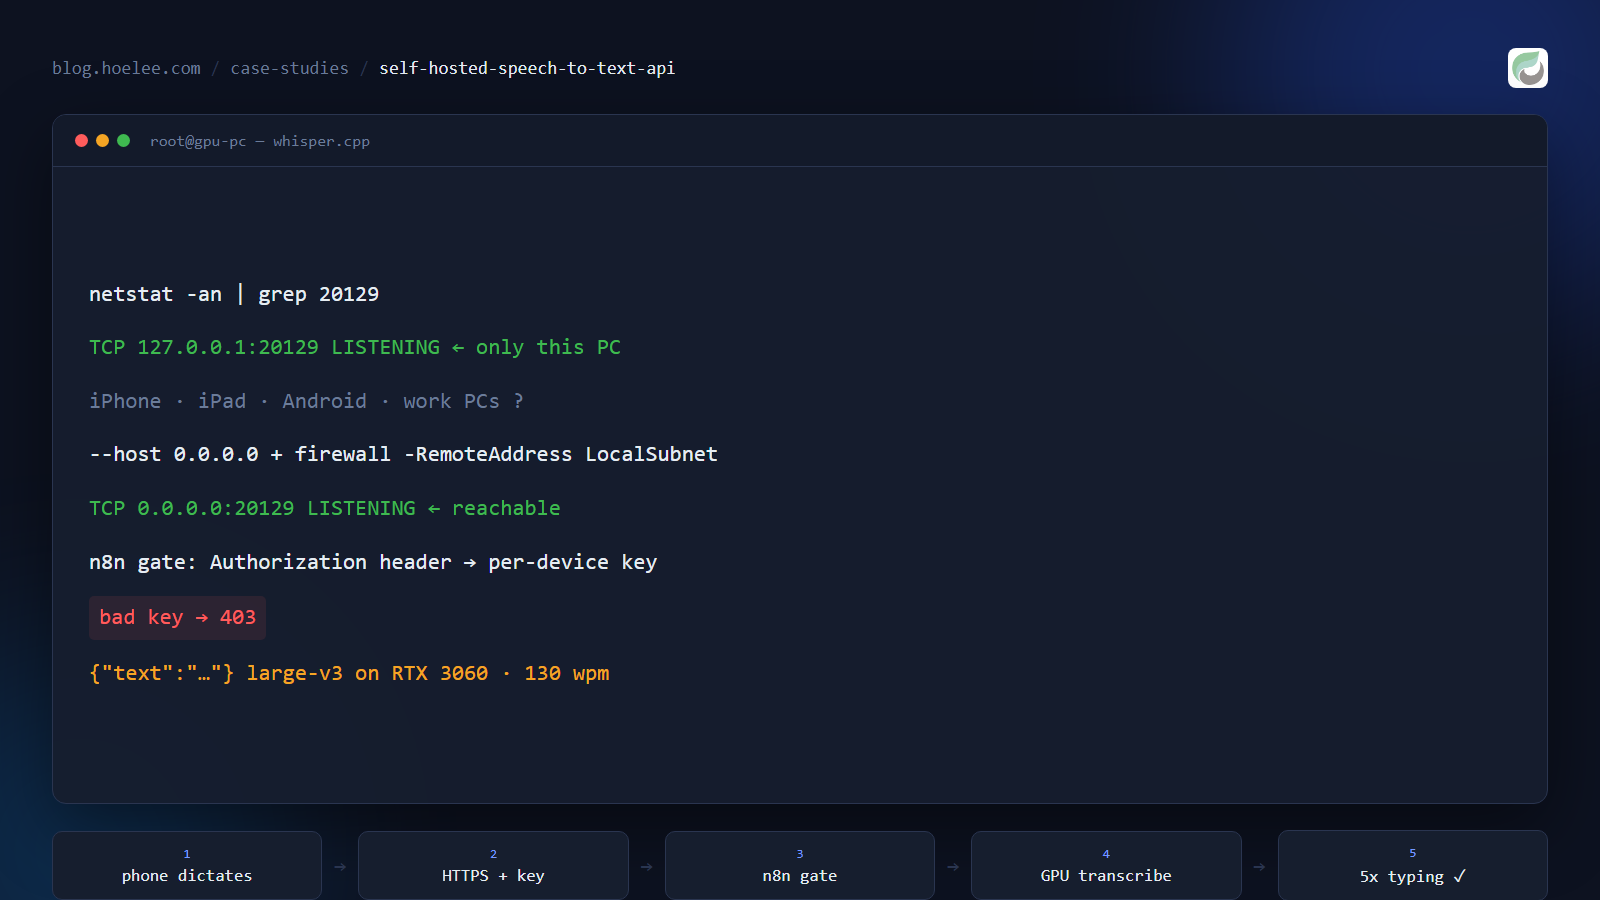
netstat -an | grep 20129
#   TCP    127.0.0.1:20129    0.0.0.0:0    LISTENING     ← 只有你能连
改掉绑定,情况就不一样了:
--host 0.0.0.0 TCP 0.0.0.0:20129 0.0.0.0:0 LISTENING ← 网络能连了**先看绑定,再去碰防火墙。**这两种故障的表现完全一样——连接超时——而只有其中 一种真的是防火墙问题。
还有一个相关的小坑:Windows 防火墙的配置文件状态会自动恢复。一条限定
Private,Domain 的规则,在 Windows 把这个网络重新归类成 Public 之后就会
静默失效;某次更新把配置文件重新打开也有同样效果。规则要按网段限定,而不是按
配置文件名称:
New-NetFirewallRule -DisplayName 'Whisper STT' -Direction Inbound -Action Allow `
  -Protocol TCP -LocalPort 20129 -Profile Any -RemoteAddress LocalSubnet
-RemoteAddress LocalSubnet 让它在内网可用、在公网不可达——即使前面已经有
认证,这也才是正确的姿势。
坑三:n8n 会把你的音频丢掉(两次)
把 n8n 放在链路里是刻意的——API key 校验就住在那里——但它有两个行为会静默地 把代理弄坏。
**第一:Code 节点会丢弃二进制数据。**我的流程是 Webhook → Code(校验 key)→ HTTP Request(转发音频)。Code 节点返回的是 JSON,而 n8n 的二进制负载——也就 是音频本身——根本没穿过它。随后报错:“Make sure that the previous node outputs a binary file.”
n8n 的 Webhook 节点会接收 multipart 上传并存为二进制。要在校验 key 的同时把 它保住,Code 节点必须显式把二进制引用传下去,而不只是返回 JSON。而那个 key 的 名字,你绝对猜不到:
┌──────────────┬────────────────────────────┐
│ 上传的字段名  │ n8n 里的 binary key         │
├──────────────┼────────────────────────────┤
│ file         │ data0                      │
│ (第二个)    │ data1                      │
└──────────────┴────────────────────────────┘
multipart 字段叫 file,但 n8n 把它索引成 data0。转发 $binary.data 会失败,
$binary.data0 才行。
**第二:执行记录会把音频存下来。**n8n 默认保留执行数据——包括二进制负载——也 就是说每一次口述都会被写进工作流数据库。对音频来说这是不可接受的。关掉它:
"settings": { "saveDataSuccessExecution": "none" }⚠ 这是最有杀伤力的一个坑。如果你通过 n8n API 改工作流而漏掉了 settings
对象,这次更新会静默重置它,于是你又开始记录音频了。系统不会有任何提示。
每次改完工作流都要验证:
curl -s -H "X-N8N-API-KEY: $KEY" \
  http://localhost:5678/api/v1/workflows/<id> \
  | jq '.settings'
坑四:nginx 自带的默认配置劫持了 80 端口
我的网关是一个 nginx 容器。它对那些明明配置好的路径一直返回 404——因为自带的
default.conf 同样在 80 端口声明了一个 server 块,而它作为默认 server 抢走了
流量。我的配置加载正常、内容正确,只是根本收不到请求。
# 启动前删掉自带配置
command: >
  sh -c "rm -f /etc/nginx/conf.d/default.conf && nginx -g 'daemon off;'"
同一个构建里还有两个小经验,部署到 NAS 之前值得先知道:
- 不能挂载一个还不存在的配置文件——部署会失败,报 “Bind mount failed:
… does not exist.” 在 DSM 上,从另一个容器里把文件写出来这个常见绕法也不行,
因为容器只看得见自己的挂载,看不见真正的主机文件系统。我最后把配置 base64
内嵌进 compose 的
command,启动时再写出来——完全不需要碰主机文件系统。 - 容器能看到的
/volume1挂载是只读的,所以那些看上去能写的路径都是封的。
授权模型,说实话
两层,值得讲清楚每一层到底买到了什么。
**每台设备独立的 API key。**每台设备有自己的 key,所以挂失一台手机不影响其他 设备:
{
  "iphone":  "stt_<random>",
  "ipad":    "stt_<random>",
  "laptop":  "stt_<random>"
}
n8n 工作流拿 Authorization 头去比对这份名单,不匹配就返回真正的 403。有个
细节:API key 放在 URL 查询串里会落进代理日志和浏览器历史——始终放在请求头。
这层保护了什么。它阻止别人白用你的 GPU,也让这个端点不至于变成互联网上一个 人人可用的转写服务。它不负责加密音频——那是代理层的 TLS,这也是公网入口 只走 HTTPS 的原因。
这是一个私有服务的访问控制,不是一个加固过的公开 API。目前没有限流,也没有 按 key 的配额。对于几台已知设备的内网办公部署,这个比例是合适的;如果要开放给 第三方,那就得再加上限流、日志和轮换。
如果重来一次
- **先验证绑定地址,而不是防火墙。**两个小时花在测错误的层上,而这件事
netstat一行就能回答。两种故障都表现为”连接超时”,而我本该知道 loopback-only 不管防火墙什么状态都会拒绝一切。 - **确认安装程序到底装了什么。**我把
nvcc --version当成了工具链可用的证据。 一个能跑、但找不到自己头文件的编译器,并不算装好了——而它的报错不会告诉你 这一点。 - **在搭管线之前就定好日志策略,而不是搭完之后。**我是在构建过程中设上
saveDataSuccessExecution: none的,但同一次修改如果走 API 就会静默地把 音频留存重新打开,毫无提示。能被无关操作重置的隐私设置,需要一个验证步骤。
结果
四类设备——一台 Windows 开发电脑、iPhone、iPad、Android——都在通过我自己网络上 的一张 GPU 做语音输入。短句转写通常远低于一秒,穿过四层之后的完整请求大约 2 秒返回真实文本。
最值得说的量化收益是显存。因为模型空闲时会卸载,一个开关就能把 GPU 占用从 4,906 MiB 降到 1,321 MiB——回收约 3.6 GB——机器可以回去做开发、本地大模型 推理或图像生成,下一次口述时再把模型加载回来。
关于速度,说句公道话:大约比打字快 5 倍这个数字对散文体(说话 130 wpm 对比打字约 40 wpm)是成立的。写代码就没这么夸张,因为那更多是在思考而不是在 打字。收益最大的是办公室真正被淹没的那部分工作——邮件、文档、笔记、合约、 客服回复。
这套东西能用在你的公司吗?
部件都不花哨,回报却很直接:一台带 GPU 的机器、开源软件,再加一层负责认证的 分发层。没有按人头的月费,没有分钟数配额,没有音频离开你的场地——全公司从打字 切换到语音输入。
我做的就是这类内部基础设施:带正规认证的自建服务、能合理共享硬件的 GPU 负载, 以及让它们在员工手上已有的设备里真正可用的集成层。如果你想让语音转文字(或者 其他内部 API)跑在你自己的硬件上——哪怕是公司现成的一台工作站——这正是我在做 的事。
联系我:[email protected] 或 WhatsApp +60 12-797 2969,也可以看看我在做什么: hoelee.com。