NocoDB 附件字段怎么改都不生效,和一个漏网的正则
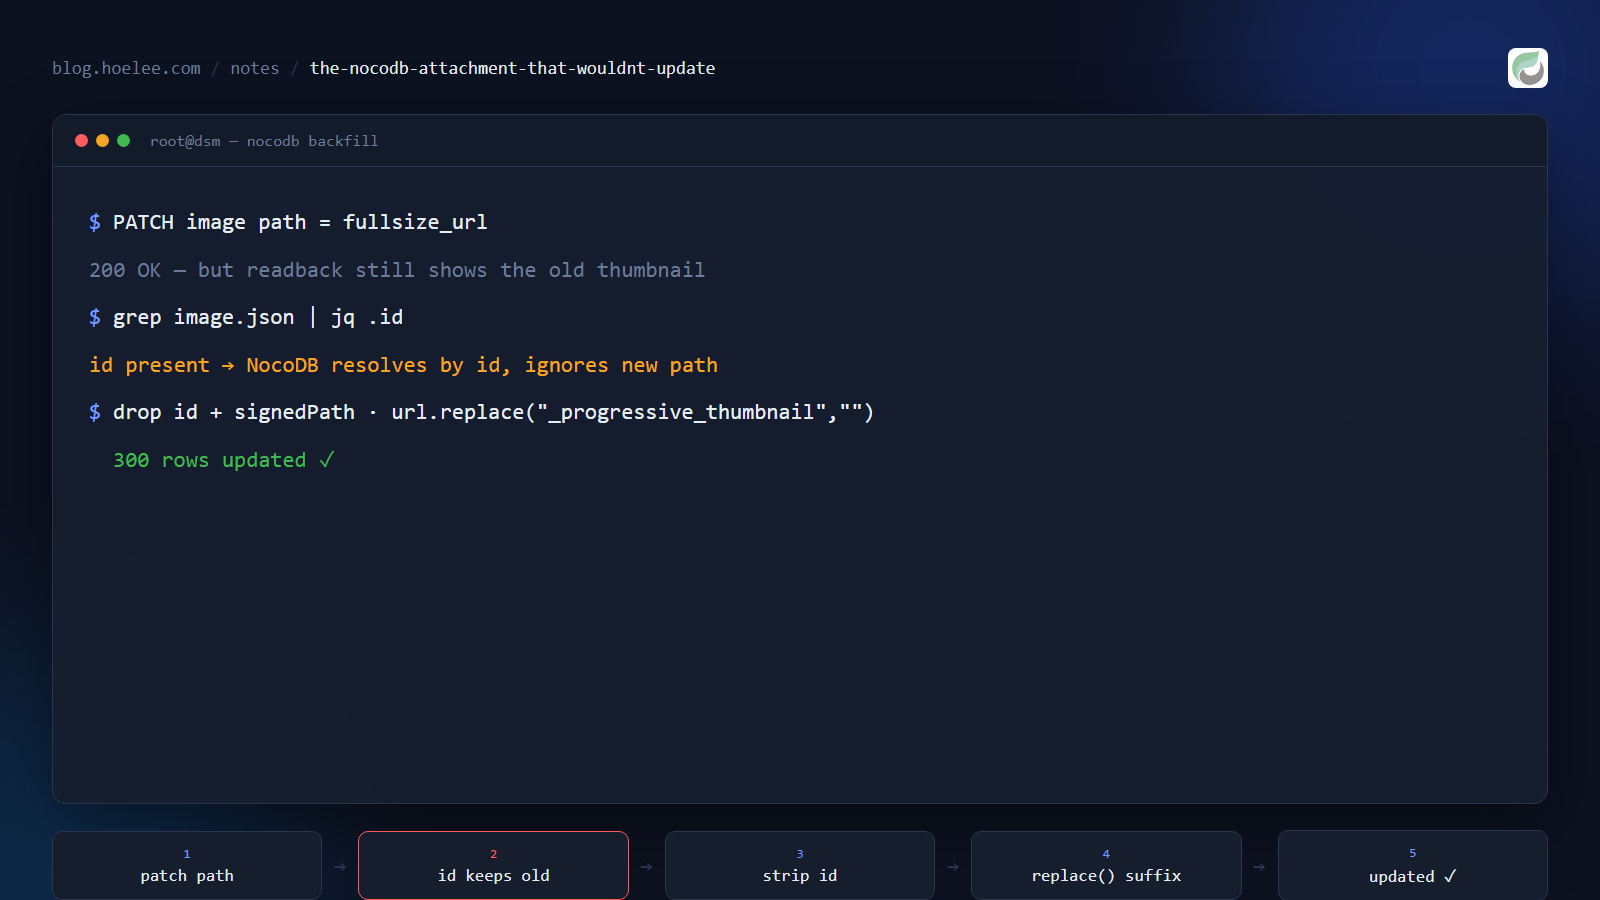
在 NocoDB 里回填 300 行数据的经历,暴露了两个小坑,每一个都耗掉了我一段时间。 它们都属于那种「只有当你修的数据恰好接近、但又没完全符合代码假设的形状时」 才会咬你的 bug。
坑 1:Attachment 改了 path 没用,只要你还留着 id
我想把一个 Attachment 列里的缩略图 URL 全部换成高清版。直觉上就是去改这个 列存的 JSON:
img = json.loads(row["image"])          # [{"id": "...", "path": "...", "signedPath": "..."}]
img[0]["path"] = new_fullsize_url
img[0]["signedPath"] = new_fullsize_url
它看起来成了——PATCH 返回成功。但把行读回来,每个 path 还是旧的缩略图。
元凶是:这个附件带着一个 NocoDB 生成的 id,只要它还在,NocoDB 就会按这个
id 去解析附件,然后心安理得地无视新的 path。我以为自己在更新的那个字段,
其实是只读的,只要 id 还在。
修复的办法是丢掉服务端分配的字段,让 NocoDB 从头重新注册这个附件:
img[0] = {
    "path": new_fullsize_url,
    "mimetype": "image/jpeg",
    "title": img[0].get("title", "image.jpg"),
}
# 不要 "id",也不要 "signedPath" —— NocoDB 会重新分配
没有 id 之后,NocoDB 会根据 path 注册一个新附件,并生成一个新的签名 URL。
这下值才真正写进去了。
规则: 如果 NocoDB 的 Attachment 改来改去都不生效,检查一下 id 字段。
把它剥掉、重新注册,而不是原地打补丁。
坑 2:一个会悄悄跳过「无扩展名 URL」的 lookahead 正则
为了拼出高清 URL,我需要去掉 _progressive_thumbnail 这个后缀。第一版我用了
一个 lookahead:
clean = re.sub(r"_progressive_thumbnail(?=\.\w+$)", "", url)这对这种情况有效:
...70776f54_progressive_thumbnail.jpg → ...70776f54.jpg ✅但 Carousell 有两种 URL 形态。有些缩略图以光秃秃的后缀结尾,没有扩展名:
...f94af259_progressive_thumbnail → (lookahead 匹配不上) ❌因为 lookahead 要求结尾是 .\w+,第二种形态就漏掉了——300 行里有 25 行。
这个正则「没报错」,它只是在那部分数据上什么都没做。
更稳的写法是直接 replace,两种形态都能覆盖:
clean = url.replace("_progressive_thumbnail", "")规则: 当你要规范化一个有多种真实形态的字符串时,除非你已经把所有形态都
枚举清楚了,否则优先用 replace() 而不是正则。一个悄悄跳过的正则,比一个
直接报错的更糟。
这里头没什么高深的东西。但这两类都是那种只有在真实数据里才会现形的无聊 bug——一个 API 信誓旦旦说更新成功了的附件,一个匹配了 91% 行、却对剩下 9% 一声不吭的正则。如果你给 NocoDB 回填数据时总觉得「只生效了一半」,先来查这两 个地方。