在多台机器之间同步一个会自我学习的 AI Agent
我的 agent 会学习。每当我带它走一遍不平凡的工作流程——如何发布到 Gitea、如何排查一个时好时坏的 Docker 容器、如何写一条 Shopee 商品列表——它就会把过程存成一项 skill:一个下次遇到同类任务时自动加载的可复用流程。几个月下来,它累积了 172 项技能,横跨二十个分类。它们就是我的第二大脑。
问题在于:这个大脑只存在于一台机器上。当我换到另一台电脑工作时,agent 就变”笨”了——它不知道我在第一台机器上教过它什么。
这篇文章讲的是我如何让 agent 的知识跟着我在机器之间流动,为什么那个显而易见的做法会悄悄毁掉工作成果,以及最后发现最关键的那个决定。
为什么这很重要
如果你在运行任何会自我学习的 agent——Hermes、Claude Code、Codex、Cursor——你都会遇到一模一样的问题。agent 在本地累积知识,但这些知识不会跟着你走。你要么在每台机器上重新教它一遍(毫无意义),要么让两份副本逐渐漂移、直到互相矛盾(更糟)。
正确地解决它需要三件事,也正是任何工程师在同步任意状态时都关心的三件事:
- 一个共享的真相来源——一份两台机器都能拉取的权威副本。
- 不静默丢数据——同步绝不能覆盖你在另一台机器上做过的工作。
- 一个决策点——当两台机器改动了同一处内容时,由你来做选择,而不是让工具替你决定。
把这三件事做对,你的 agent 在两台机器上就是同一个人。做错了,你就得花一个周末去重建一个被错误的 --force 抹掉的技能。
三种官方机制
Hermes 提供了三种迁移 agent 的方式,它们回答的是不同的问题:
| 需求 | 机制 | 命令 |
|---|---|---|
| 只要技能 | Skills Hub “tap”(一个 SKILL.md 文件夹的 git 仓库) | hermes skills tap add + install |
| 整个 agent、带版本、可拉取更新 | Profile distribution(git 仓库 + distribution.yaml) | hermes profile install / update |
| 一次性迁移 / 备份 | 导出文件(.tar.gz) | hermes profile export / import |
对于”同一 agent 在两台机器上”,profile distribution 才是持久的答案。它把整个 agent——SOUL、配置、技能、定时任务——打包成一个 git 仓库,另一台机器用一条命令就能拉取更新。
我所有东西本来就用 Gitea(git.hoelee.com),所以在那里放一个 distribution 仓库是顺理成章的。没有新工具、没有新账号,也符合我每个项目都遵循的”Gitea 优先”惯例。
我差点踩进去的坑
distribution 安装器有一个安全特性,听起来像限制,却恰恰是救命的东西:它拒绝安装到 default profile 里。 你必须给它一个命名 profile。
这不是麻烦。第二台电脑本来就有自己的 agent 和项目相关的技能。如果我把它覆盖安装上去——或者用了会覆盖现有 profile 的 --force——我就会删掉那台机器本地的成果。default 拒绝机制就是那道护栏,逼着你在现有 agent 旁边安装,然后再合并。
而这正是整个练习真正的教训:合并才是产品本身。 同步不是”复制文件”,而是调和两个都以为自己是真相来源的 agent。
那个差点让我翻车的目录事实
这里是微妙的部分,也是那种”看起来没事、直到出事”的坑。
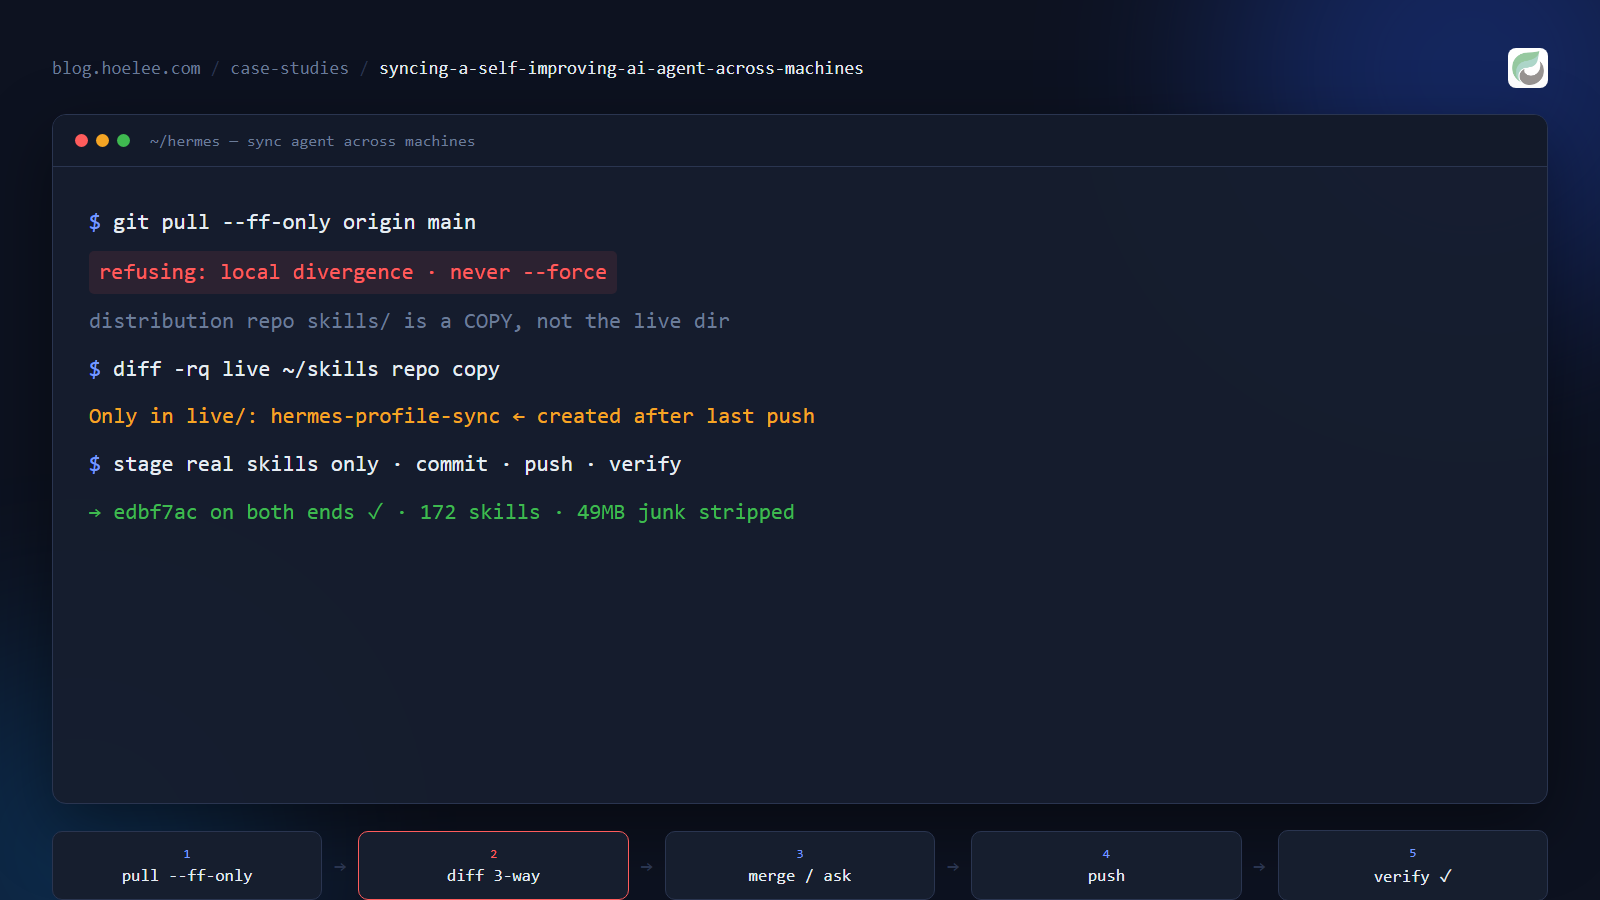
distribution 仓库里放的是技能树的副本——它不是活跃目录。活跃技能在 ~/AppData/Local/hermes/skills/(agent 真正写入的地方);仓库副本只是我推送的一份快照。它们是两棵会漂移的、互相独立的树。
所以一次同步实际上涉及三方,而不是两方:
活跃技能目录 ←→ 仓库副本(D:\dev\hoelee-agent-dist\skills) ←→ Gitea 远端我在上次推送之后新建的一个技能,只存在于活跃目录里。如果我假设仓库副本是权威、并”从它开始同步”,就会静默删掉那个技能。所以每次同步前我做的第一件事,就是比对两棵树:
diff -rq ~/AppData/Local/hermes/skills D:/dev/hoelee-agent-dist/skills漂移是正常的,不是错误。整套纪律在于搞清楚三方里谁领先,然后有意识地调和。
为什么我手动同步,而不是用 cron
这是最关键的决定,而它归结为冲突策略。我想要双向同步——两台机器都会编辑技能——而当两边编辑了同一个技能时,我想两边都保留、由我自己来挑,而不是让工具静默丢掉其中一个。
这种策略本质上是交互式的。一个自动拉取的 cron 要么覆盖成果,要么在我没盯着的时候触发。所以我让触发变成手动:我说一句*“同步技能”*,agent 就去执行,并在任何冲突时停下来问我。这不是偷懒——而是合并的决定权在我手里,自动化做不了这个决定。
我记录下来的(也是现在真正在跑的)流程是:
# 1. 把远端拉进仓库副本,只快进——绝不 force
cd D:\dev\hoelee-agent-dist && git pull --ff-only origin main

# 2. 调和活跃目录 ↔ 仓库副本
diff -rq ~/AppData/Local/hermes/skills D:/dev/hoelee-agent-dist/skills

# 3. 只暂存真正的技能内容(绝不包含 curator 垃圾)
# 4. 提交 + 推送,然后验证远端确实有了
git ls-remote origin main   # 必须等于本地 HEAD
如果拉取被拒绝,或者 diff 显示同一个技能在两边都被改过,我就停下来做决定。绝不 --force,绝不 reset。
那坨悄悄撑大仓库的垃圾
第一次打包时的一个具体数字:我的技能目录有 57 MB,但真正的技能内容只有 ~8 MB。剩下的是 agent 的 curator 不断写入的运行时状态——一个 40 MB 的 hub 索引缓存、curator 备份、使用统计、一份账本。
这些都不该进共享仓库。它们每天都在变、是机器本地的、而且会让每次同步都变成一团糟。一个 .gitignore 就能把它们剥掉:
# skill 运行时垃圾——绝不入库
skills/.hub/
skills/.curator_backups/
skills/.curator_ledger.jsonl
skills/.usage.json
skills/.bundled_manifest
当你打包一个会自我学习的 agent 时,会发现它不只是文件——是文件加上一层必须挡在外面的簿记。跟给 node_modules 写 .gitignore 是同一个道理,只不过对象是你自己的记忆。
我会做得不一样的地方
- 先想清楚触发方式,再选机制。 我花了不少功夫纠结 distribution 还是 export,却还没回答”我要手动还是自动”——而这个答案反过来会改变机制。如果我一开始就知道要的是手动的、冲突感知的同步,第一天就会照这个方式去设计脚本。
- 把”副本 vs 活跃目录”的区分当作一条有名字的不变量。 我是靠 diff 才发现的;它本该从第一次
cp -r起就写进我的笔记里。 - 提前决定每台机器的
user_id。 技能走 git 同步,但情节记忆(mem0)是另一个后端——两台机器要么共享一个记忆桶、要么各留各的,这是一个应该早点明确的单行配置选择。
结果
现在我有一个 git 仓库——git.hoelee.com/hoelee/hoelee-agent-dist——装着 172 项技能、我的配置、SOUL 和定时任务。另一台机器把它装进一个命名 profile,再把自己本地的技能合并进去,我们靠一个”每次冲突都问我”的手动触发器保持同步。第一次真正的同步推送了一个只存在于活跃机器上的技能,验证它落地了(两边都是 edbf7ac),并且没有动任何现有的技能。
给任何想同步 agent 的人的一句实在话:文件是简单的——git 干了大部分重活。难的是那些护栏:那个你绝不能跑的 --force,那个你绝不能误当成真相来源的副本,还有那个你绝不能让工具替你静默解决的冲突。
想为自己的 agent 搭建这套东西吗?
我为企业和个人搭建自托管的 AI 基础设施——agent、bot、自动化。如果你正在跨机器运行 agent(或想开始),或者需要自托管工具方面的帮助,我很乐意聊聊:
- 📱 WhatsApp: +60 12-797 2969
- 📧 Email: [email protected]
- 🌐 Website: hoelee.com