确定性的活,别再用 Agent Prompt 去跑
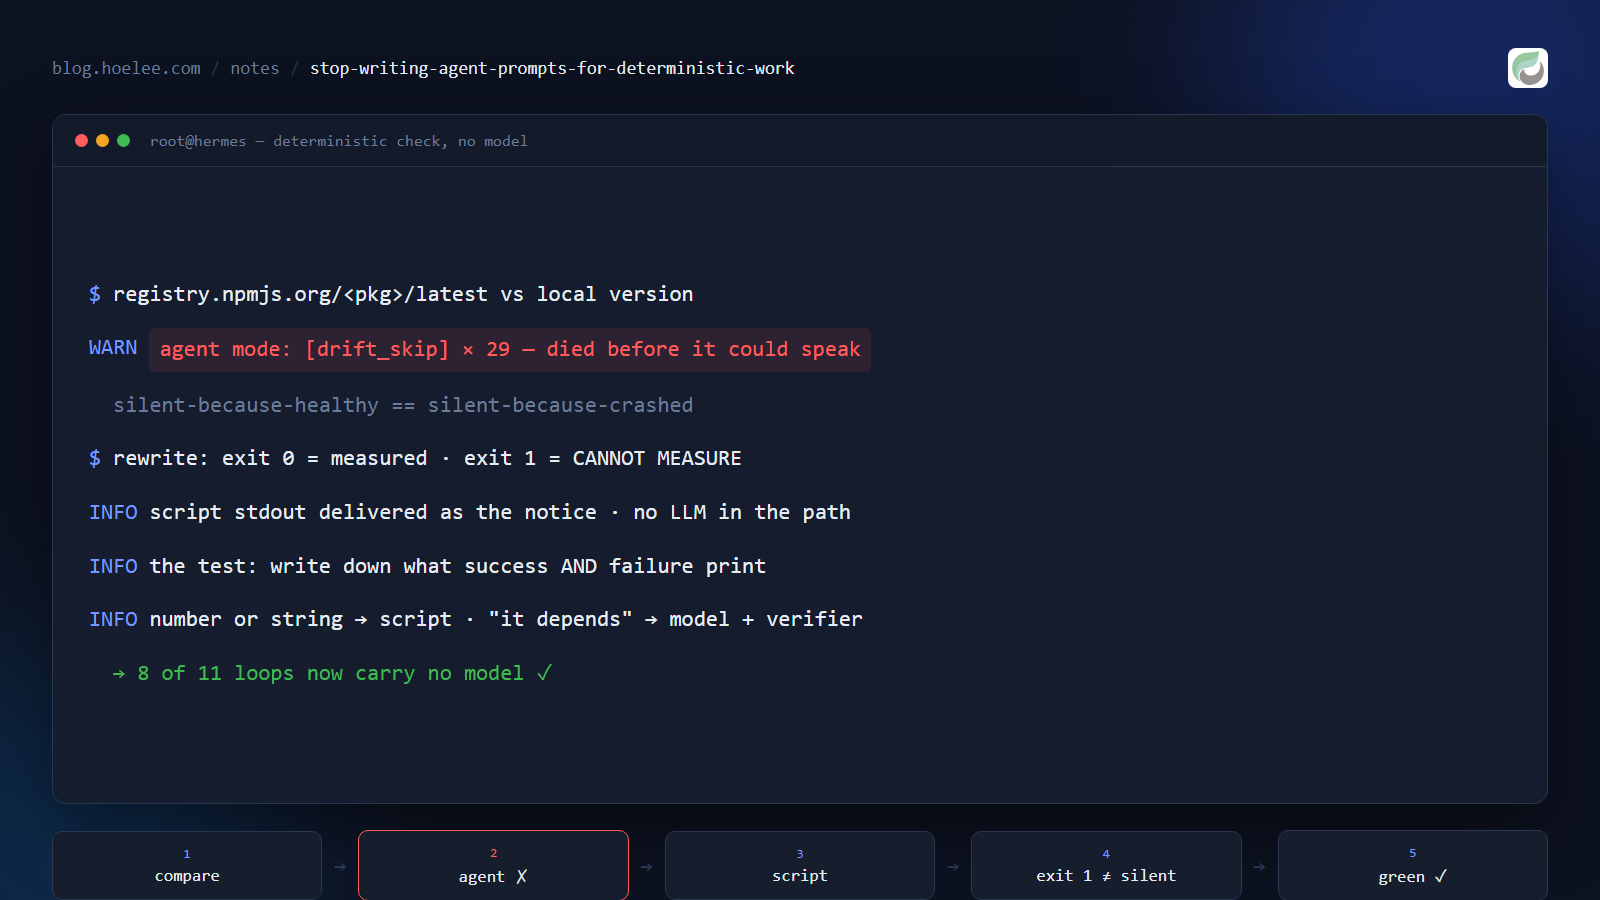
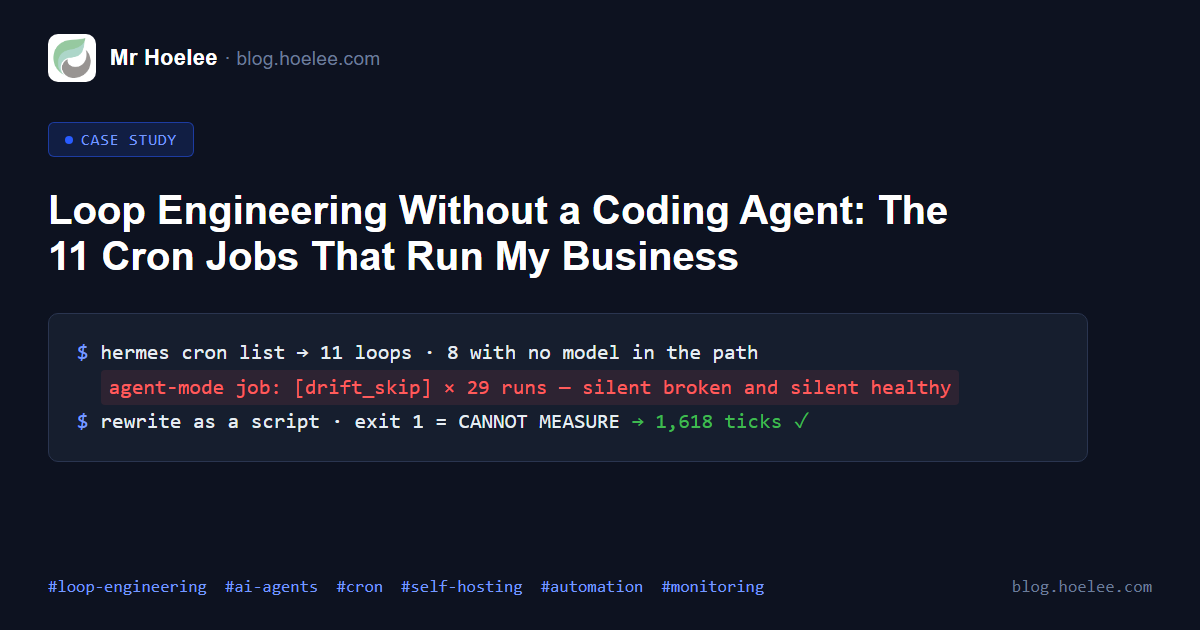
我有一个定时任务连续失败了 29 次。没人告诉我,因为它被设计成只在有东西可报的时候才开口——而一个还没来得及开口就崩掉的运行,看起来和一个「什么都没发现」的运行一模一样。
那个任务是个版本检查:问 npm 某个我常用的 CLI 最新发布版本是多少,和本机装的版本比一下,有更新就告诉我。整个任务就这些。它就是两个字符串加一次比较。
我当初把它做成了 agent 任务,因为那阵子我脑子里的默认模式就是这个。每次 tick,模型读一遍注入的脚本输出,然后判断要不要写一条通知。它正常跑了一阵子。后来我改了全局默认模型,而这个任务会记录自己创建时的模型,于是它干脆整个不跑了,打印一行 [drift_skip] 就退出。连续 29 次。
修法不是写一个更好的 prompt,而是把模型从循环里删掉。
规则
如果停止条件是一次比较——一个字符串、一个数字、一个状态码——那么循环里的模型只能带来新的失败模式。
「3.8.50 是不是比 3.8.50 新」这件事里没有任何判断可做。模型并没有在决定代码决定不了的事;它带来的是一条依赖(一条模型路由、一个提供商、一份配置快照、一张 token 账单)和一种全新的出错方式。所以我把它重写成 125 行 Python,每条分支都有明确出口,再把任务切成脚本模式:脚本的 stdout 直接作为通知内容,整条路径上没有任何 LLM。
从此一路干净。Anthropic 自己的建议也是一句话——确定性的活用脚本,跑脚本比让模型去推理步骤便宜——但对我来说成本从来不是重点,可靠性才是。
模型该用在哪
我跑的 11 个循环里,现在有 8 个整条路径上没有模型。用模型的那 3 个,处理的都是我确实写不成代码的东西:
- 这封邮件重不重要? 一个邮箱里同时有促销、DMARC 报告、容器告警,和一位来问报价的客户。抓邮件是确定性的,给它排优先级不是。
- 这张店铺优惠券是不是快超支了? 算术很简单;判断一个发现对我已经承诺出去的钱意味着什么,不简单。
- 这个项目是不是卡住了? 读两个 markdown 文件是脚本的活。发现「计划已经三周没动过」不是。
我给新循环做的测试是:写下这个检查在成功和失败时分别会打印什么。 如果两个答案都是一个数字或一个字符串,那它就是脚本。如果答案是「要看它说了什么」,那它需要模型——而这时候它就需要一个我比 agent 更信任的验证器,因为我已经无法预测输出了。
真正咬到我的是哪一部分
失败模式不是 drift,是沉默。
一个只在出事时才开口的循环,是我唯一能忍受的那种——我不想让 11 个任务每天给我发状态报告。但「健康所以安静」和「崩了所以来不及开口」,从我手机这端看是同一个现象。29 次运行的证据一直躺在那个任务的执行日志里;我却一直在相信「没有通知」这件事本身,而没去读历史。
所以现在这套脚本都多了一条出口:退出码 0 表示量过了,这是结果,退出码 1 表示我量不了——而退出码 1 永远不静默。配置缺失、状态文件解析失败、没预料到的异常:全都打印一行并退出 1。就这一处改动,本该让这个 bug 在第 1 次就暴露,而不是第 29 次。
如果你有一个循环「已经安静一阵子」了,先去翻它最近十次运行,再下结论说它正常。这条建议花了我三个星期才换到。
简短版
- 确定性的检查 → 脚本。判断 → 模型。别为了方便把两者混在一起。
- 给「成功则静默」这条约定开一个例外:「我量不了」必须永远大声。
- 去读 runner 自己的执行历史,而不是只看你收到的通知。
想给你的网站或网店也做一套这样的东西——可用性、证书、备份、以及只在真的有事时才 ping 你的邮件?WhatsApp +60 12-797 2969 · [email protected] · hoelee.com