浏览器翻译没有 API:我给一个纯中文网页应用加上了英文模式
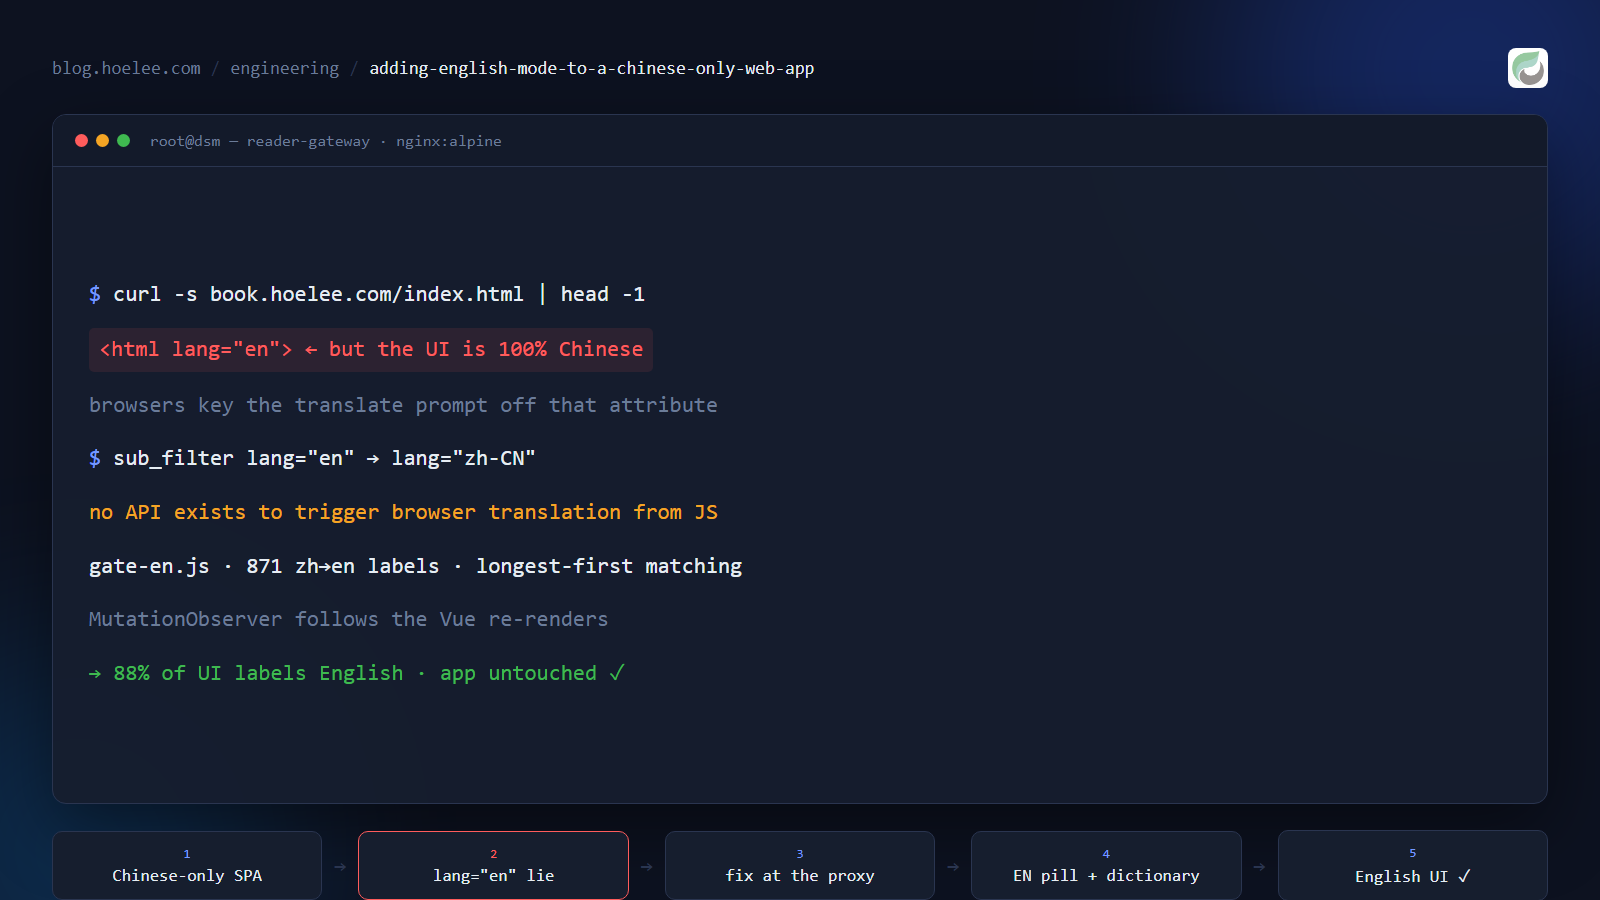
「能不能用 JavaScript 触发浏览器自带的翻译?」答案是不能。接受这一点花了我一个下午 —— 但更有意思的发现出现在前面:我的应用其实一直在破坏浏览器的翻译功能,而且只用一个属性就做到了。
我在做什么
我维护着一个私人的邀请制阅读平台 book.hoelee.com:自建的阅读器(Kotlin/Spring 后端 + Vue 单页应用),装着我自己的藏书,并给受邀读者开了账号。界面是纯中文 —— 不是「以中文为主」,而是只有中文。我在相信这一点之前把每个前端 bundle 都翻了一遍:没有 i18n 库、没有语言包、没有语言切换,只有一个简繁转换表和一堆英文 TTS 语音名。
后来我开始把邀请卡发给只说英文的读者。他们能注册,然后迎面撞上:书架、浏览书仓、确定、设置 —— 每一个控件都在他们读不懂的语言里。这不是「体验不够精致」的问题。对我邀请的一半人来说,这个产品是不可用的。
有一条约束决定了后面所有做法:我不改这个应用。 它的上游仓库已经归档,界面是压缩过的 Vue bundle —— 任何我打进镜像里的补丁,都会在下一次换镜像时消失。所以我做的东西必须待在外面一层:我已经架在应用前面的那个 nginx 网关。
发现一:应用声明了自己错误的语言,而这会关掉翻译
写代码之前,我先看看浏览器到底看到了什么:
$ curl -s https://book.hoelee.com/index.html | grep -o '<html[^>]*>'
<html lang="en">
外壳声明英文,界面 100% 中文。
这件事比看上去严重。Chrome、Edge、Safari 决定「要不要主动提示翻译」,很大程度取决于页面声明的语言。一个声明自己是英文、却渲染中文内容的页面,不会得到那个「要翻译此页面吗?」的提示 —— 对我的新读者来说最有用的一项无障碍功能,就这么被悄悄关掉了;而「右键 → 翻译成中文/英文」是大多数人从来不知道的操作。
修复只要一行,而且是作用在响应出站时,不是打进应用里:
location = /index.html {
    # sub_filter 不能改写 gzip 后的内容 -> 让上游返回未压缩的 HTML
    proxy_set_header Accept-Encoding "";
    sub_filter_once on;
    # 应用声明 lang="en" 而界面是中文 -> 浏览器因此永远不提示中译英。
    # 说出事实。
    sub_filter '<html lang="en">' '<html lang="zh-CN">';
    proxy_pass http://hectorqin-reader:8080;
}用发现它的方式验证:curl -s https://book.hoelee.com/index.html | grep -o '<html lang="[^"]*"' → <html lang="zh-CN"。声明的语言正是翻译提示的判断依据,页面终于声明中文之后,提示才可能正常出现。(具体提示仍取决于各浏览器与其语言设置 —— 我在链路上验证的是那个属性本身。)因为改写发生在代理层,应用怎么升级都不会失效。
发现二:浏览器翻译没有 API
页面老实之后,下一个问题自然是:我能不能自己提供一个按钮,做浏览器菜单里那件事?没有这样的 API。 浏览器翻译是 UI 层功能,网页无法调用它,也没有任何暴露给网页的接口可以脚本化它。
于是我逐个排除了替代方案:
| 方案 | 为什么放弃 |
|---|---|
| 改写应用的 JS bundle 来替换文案 | 把自己绑死在压缩后的内部实现上,下次换镜像就坏。也违背了「不改应用」的原则。 |
用 translate.goog 代理整站 | 那是另一个源(origin)。应用的登录令牌存在 localStorage 里,而它是按源隔离的 —— 读者会变成未登录,Service Worker / PWA 也会坏掉;而且每个 API 调用都要绕道 Google。 |
| 教读者右键 → 翻译 | 对书籍正文有用,但它是一次一浏览器的手动仪式,对根本不知道有这功能的人毫无帮助。对一个我自己掌控全栈的产品来说不够。 |
| Fork 应用,正经加 i18n | 在一个已归档的代码库上做几周,而且上游一变我就得重译一遍。 |
剩下的就是最不花哨的那条路:自己用一个词典在浏览器里翻译界面 —— 再把它包进一个只在应用内出现的按钮。
做法:词典 + 按钮,在网关层注入
网关本来就在提供我的前台页面,那它再多提供一个静态文件、只往应用外壳里注入一个 script 标签就行:
location = /gate-en.js {
    root /usr/share/nginx/html;
    add_header Cache-Control "public, max-age=300" always;
}

location = /index.html {
    # ... 上面的 lang 改写 ...
    sub_filter '</head>' '<script src="/gate-en.js" defer></script></head>';
    proxy_pass http://hectorqin-reader:8080;
}
整个部署就是这样:一个 40 KB 的脚本,只在 /index.html 加载,所以按钮只存在于应用内,别处都没有。脚本做三件事。
1. 从应用自己的 bundle 里「收割」词汇表
界面文案本来就在压缩后的 JavaScript 里,以字符串字面量的形式存在。把所有含中日韩字符的字符串抓出来并计数:
import re, collections
CJK = re.compile(r'[\u4e00-\u9fff]')
count = collections.Counter()
for bundle in bundles:
    for m in re.finditer(r'"([^"\\\n]{2,40})"', bundle):
        if CJK.search(m.group(1)):
            count[m.group(1)] += 1
print(len(count))   # 840 条唯一字符串,按出现频率排序
跑出 840 条唯一字符串:菜单(书架、书源管理)、确认框(确认要删除所选择的书籍吗?)、设置项(段落行距)、错误信息(本地书籍源文件不存在)。词典最终是 871 条 —— 收割来的,加上我在英文模式下实际使用应用、看还有什么没翻而补上的。
2. 按 DOM 的真实样子匹配,而不是你希望的样子
朴素的子串替换会毁掉中文词组:书架 就藏在 加入书架 里面,单字更糟(页 藏在 页面 里)。三条规则解决了它:
- 先做整标签匹配,基于去掉空白后的文本。 应用里的标签是
" 书架 "这种带空格的,所以词典里的设置必须能匹配 DOM 里的" 设置 "。 - 然后是最长优先的子串替换,只允许长度 ≥ 2 的键参与。
- 单字键只做整标签匹配(章、页、条),这样它们永远不可能破坏更长的词。
function tr(s) {
  if (!s || !CJK.test(s)) return s;
  var hit = EXACT[s.replace(/[\s\u3000]/g, '')];   // 整标签匹配,空白归一化
  if (hit) return keepWS(s, hit);
  var t = s;
  for (var i = 0; i < KEYS.length; i++) {          // KEYS:最长优先,长度 >= 2
    if (t.indexOf(KEYS[i]) >= 0) t = t.split(KEYS[i]).join(DICT[KEYS[i]]);
  }
  // 收拾数量短语:共58个可用书源 -> "58 usable sources"
  return t.replace(/共\s*(\d+)/g, '$1').replace(/(\d+)\s*个/g, '$1').replace(/(\d)([A-Za-z])/g, '$1 $2');
}
3. 跟上框架的重绘
它是 Vue 应用,DOM 一直在被重写 —— 只跑一次的翻译,一秒后就有一半是错的。一个带 150 ms 防抖的 MutationObserver,在任何变化之后重跑一遍遍历。
这一遍是幂等的:标签一旦变成英文就不再含中日韩字符,于是不会被再写一次,也不会形成写入循环。文本节点之外,placeholder、title、aria-label、alt 和输入框的 value 也会翻译 —— 所以提示气泡和搜索框也一起变英文了。
UI 是右下角的一个小胶囊:关闭时显示 EN,开启后显示 中文,选择记在 localStorage,还提供「隐藏此按钮」给更愿意用自己翻译器的读者。
它刻意不翻译什么
书籍正文。 阅读器把 EPUB 内容渲染在 iframe 里,我的遍历器按设计跳过 iframe —— 而且我无论如何也不会去机器替换一本小说的正文。
同样保持原样的还有:书名与作者、书源名称、我自己建的分组名(梯子、精品、正版),以及应用那句诗。这些是数据,不是界面。翻译界面是一种体贴;悄悄改写用户自己的内容是另一回事,而且糟糕得多。
书籍正文仍然交给浏览器自带的翻译 —— 而且因为「发现一」,它现在真的会被提示出来。按钮的弹窗里就是这么写的。
要量,不要用眼睛看
「截图看起来基本是英文了」不算结果。我在开关按钮的前后,数了实时 DOM 里含中日韩字符的文本节点:
let cjk = 0, total = 0;                          // 遍历器跳过注入的 UI 与 script/style
while ((n = walker.nextNode())) {
  const t = n.nodeValue.trim();
  if (!t) continue;
  total++;
  if (/[\u4e00-\u9fff]/.test(t)) cjk++;
}| 界面 | 之前 | 之后 | 已翻译 |
|---|---|---|---|
| 登录 / 注册对话框 | 80 | 12 | 85% |
| 书架 + 设置 | 259 | 60 | 77% |
| 阅读页界面 | 214 | 31 | 88% |
那些界面里仍被计为中文的,全部是数据 —— 书名、作者、书源名、我自己的分组名、那句诗 —— 正是应该保持中文的部分。
我会怎么做得不一样
不要用手工重写一份 871 条的词典。 我重构过一次,静默丢了 25 个键。症状看起来像逻辑 bug:设置 还是中文,而它的每个兄弟标签都翻译正常。匹配器没问题 —— 是条目不见了。在你相信一次重写之前,用程序对比键集合:
python -c "print(sorted(set(old_keys) - set(new_keys)))"自动化 UI 检查要写短。 我的无头运行器每次调用硬超时 60 秒。一个遍历六本书的循环返回 HTTP 408 和空 body,而我的 JSON 解析器报的是「解析错误」而不是「超时」—— 我一度在查错的东西。
调试之前先搞清楚 SPA 的真实路由。 #/reader/1 会渲染出一个空白外壳,让人以为应用坏了;真正的路由是 #/reader?bookUrl=<urlencoded>。
注意你自己的跳转逻辑。 我的网关会把任何刷新送回前台页,除非设置了 sessionStorage 的通行标记。把界面切回中文会重载页面 —— 所以按钮会先设好同一个标记,否则读者会因为改了个语言设置被踢出应用。
结果
一个只懂英文的读者,现在打开平台、点一下按钮,就能用英文读界面。应用本身没有被改动:整个功能只是一个由 sidecar nginx 容器提供的 40 KB 脚本,所以下一次换镜像不可能弄坏它;而浏览器自带的翻译,终于有一个会声明自己真实语言的页面可以配合。
我留下的经验:当平台不给你 API 时,往外看一层。 反向代理是添加「应用里加不了的行为」的正当位置 —— 而且通常是唯一能在升级中存活的位置。
我为马来西亚的中小企业搭建并自托管这类平台 —— 网页应用、私人书库、内部工具。有需要可以找我:WhatsApp +60 12-797 2969、[email protected],或 hoelee.com。